Module DevSecOps
Introduction
Imaginez, une situation pas si impossible que ça: votre entreprise vient de livrer en production, pour un de ses clients importants, un applicatif.
Cet applicatif est composé d'un ensemble de "pièces" assurant son bon fonctionnement:
- Du code, probablement en partie du javascript. Vos développeurs, plutôt que de réinventer la roue, ont utilisé de nombreuses dépendances, par exemple pour gérer les connexions à la base de données, gérer le stockage, etc
- Des secrets: identifiants de connexion à la base de données, tokens d'accès au stockage de type S3 (ou autre), etc
- Des images de conteneurs, qui contiennent les différents microservices constituant l'applicatif ainsi que l'userland nécessaire à leur bon fonctionnement, qui peut être basé sur Debian, Alpine, Ubuntu, RHEL, etc
- Images qui sont déployées sur votre infrastructure: machines physiques, VMs dans le cloud, clusters kubernetes, de base de données, etc, gérées par vos plans Terraform et/ou vos playbooks Ansible, lesquels ont aussi besoin de secrets (tokens hyperviseur, kubeconfigs kubernetes, etc) pour déployer et maintenir votre infrastructure.
Le lancement se déroule bien, les utilisateurs sont contents, mais au bout de quelques jours, bim, la base de données a fuité. Vous allez donc devoir reprendre toute la chaîne, du code source aux secrets en passant par vos builds de conteneurs et la configuration de votre infrastructure afin de déterminer l'origine de la faille de sécurité ayant permis cette fuite de données.
Ce qui veut dire:
- Revoir le code, et toutes les dépendances liées
- Vérifier qu'aucun secret n'est hardcodé
- Vérifier l'intégrité de vos images de conteneurs, l'ensemble des dépendances les constituant: avons nous une faille d'élévation de privilèges dans un des applicatifs de l'userland du conteneur (ex: sqlite installé, pas utilisé, mais permettant une élévation de privilèges, capabilities du kernel actives type CAP_SYSADMIN ou CAP_NET_RAW alors qu'elles devraient être désactivées
- Vérifier l'ensemble de vos plans Terraform, playbooks Ansible, ainsi que l'intégrité de vos hyperviseurs, clusters kubernetes, etc
Cela représente donc une masse non négligeable de potentiels vecteurs d'attaque qu'une approche DevSecOps vous aurait permis d'éviter. Evidemment, une telle masse de travail "après-coup" représente aussi un coût non négligeable pour votre entreprise, sans compter l'impact sur sa réputation vis-à-vis de ses clients.
Définition
Sous le terme "DevSecOps", on rassemble un ensemble de bonnes pratiques mettant à contribution l'ensemble des équipes de l'entreprise, des développeurs aux administrateurs systèmes et réseaux.
DevSecOps introduit la notion de responsabilité au niveau de chaque équipe. Ce n'est plus à une équipe sécurité dédiée de vérifier et contrôler le bon respect des normes de sécurité, c'est à chaque équipe d'implémenter les mesures nécessaires pour s'assurer du bon respect des normes de sécurité à l'intérieur de son périmètre: c'est au développeur de s'assurer que telle ou telle dépendance, bibliothèque de fonction, etc utilisée dans son projet ne comporte pas de failles de sécurité critique, c'est à l'administrateur système de bien s'assurer de la bonne configuration de ses infrastructures, et ainsi de suite.
La mise en place d'une politique DevSecOps au sein de l'entreprise implique donc la coopération de toutes les équipes vers un but commun: améliorer le niveau de sécurité général de l'entreprise. Cela implique aussi de mettre en place une bonne communication au sein de l'entreprise, voire, des formations dédiées.
Cependant, l'humain est faillible: oubli, paresse, pression des supérieurs pour livrer vite, etc.
Dès lors, et ce à chaque étape du cycle de vie du projet, il est important de mettre en place des tests de sécurité automatisés ainsi qu'un pipeline CI/CD sécurisé, c'est à dire qui va bloquer build et déploiement dès qu'un test automatisé de sécurité remonte un problème dont le niveau de criticité est considéré comme bloquant (Score CVSS élevé, RCE, etc).
Terminologie et éléments constitutifs
Tests automatisés
On peut définir cinq types de tests automatiques dans le cycle de vie de notre applicatif:
- SCA (Software Composition Analysis), dont le rôle est de détecter les vulnérabilités connues dans les dépendances du code de votre applicatif
- SAST (Static Application Security Testing), dont le rôle est de remonter les failles de sécurités dans le code de votre applicatif ne découlant pas de dépendances (donc introduite par l'équipe dev): injections SQL, XSS, etc, sans l'exécuter.
- Scan IaC, où on va s'assurer de la sécurité de nos plans Terraform, playbooks Ansible, etc, afin de ne pas introduire de potentielle vulnérabilité lors du déploiement de notre infrastructure.
- DAST (Dynamic Application Security Testing), dont le rôle est de découvrir les bugs visibles uniquement lorsque l'application s'exécute
- Et enfin, Secrets scanning, qui va vérifier qu'aucun secret n'est présent en dur dans votre applicatif (clefs API, identifiants, etc)
Pipeline sécurisé: les trois piliers.
Le pipeline CI/CD sécurisé va fonctionner avec des "Security Gates", c'est à dire des étapes de validation successives à chaque niveau de votre pipeline. Si une étape de validation rencontre un échec, on remonte l'incident à l'équipe concernée et surtout, on bloque tout!
Il y a trois règles importantes à retenir pour une CI/CD sécurisée:
- On bloque ce qui est considéré comme critique: faille RCE, secret en dur dans le code, etc, on ne doit pas se retrouver avec ça en prod'!
- On alerte sur des failles/CVE non-critiques, sans bloquer le build.
- Jamais de secrets en dur. Il faut utiliser des outils de type vault, SOPS, voire un fichier chiffré via GPG (si on a pas les moyens d'une vault) pour ne jamais risquer de pousser des secrets critiques sur nos dépôts git.
Il faut aussi s'assurer que la chaîne des fournisseurs (Supply Chain) est traçable et connue. C'est ce qu'on appelle la:
Supply Chain Security
Regardons les choses en face, votre application est probablement composée d'un grand nombre de composants d'origine externe. Il faut pouvoir en assurer la traçabilité.
Inventorier manuellement l'ensemble des dépendances est un processus chronophage, fastidieux et source d'erreur si on le confie uniquement à des êtres humains. Heureusement, on dispose de plusieurs outils pour s'assurer que l'on dispose bien:
- de l'inventaire de nos dépendances externes: SBOM, que nous allons voir d'ici peu
- que chaque élément de l'inventaire est authentifiable (signature cryptographique par exemple)
- de la provenance de cet élément: gestionnaire de paquets système, NPM, github, binaire fourni ou compilé à la main, qui est l'auteur, etc.
Security By Design
Vous devez probablement déjà connaître les tenants et aboutissant de la sécurité par design, qui repose sur trois principes fondamentaux:
- Le principe du moindre privilège. Votre applicatif n'a pas besoin de s'exécuter en root, votre cache web n'a pas besoin de pouvoir communiquer avec la base de données, etc.
- La défense en profondeur: chaque élément de votre infrastructure doit être sécurisé. Les communications à l'intérieur de votre infrastructure doivent être chiffrées, vous devez authentifier vos utilisateurs de façon solide, vous devez avoir mis en place une supervision complète (système, réseau, applicative, agrégation de logs, etc)
- Et enfin votre applicatif doit être sécurisé par défaut: seuls les ports nécessaires doivent être ouverts côté firewall, vos utilisateurs doivent se connecter en HTTPS, etc.
Enfin, il est important de bien analyser les risques:
Outils
Analyse des Risques (Risk Assessment)
L'analyse des risques consiste a déterminer quoi protéger en priorité sur votre infrastructure. Elle se base sur l'inventaire:
- des menaces: qui peut nous attaquer? Si votre client est un fabricant de composants utilisés sur un théâtre d'opérations militaires, par exemple, vous risquez de vous retrouver avec des attaques provenant de gouvernements hostiles, etc
- des vulnérabilités: faille logicielle, RCE, LPE, injection SQL, etc
- des risques, qui mesurent l'impact qu'aurait l'utilisation d'une faille sur votre infrastructure et sur votre business.
On ne peut pas nécessairement tout protéger de la même façon, surtout si l'on manque de moyens. Dès lors, il est important de déterminer quels éléments de votre infrastructure sont critiques, afin de pouvoir les sécuriser au maximum (hint: c'est souvent les données clients et donc la base de données :p)
SBOM: Software Bill Of Materials
Une SBOM, en français nomenclature logicielle, est une liste des composants constitutifs d'un artefact logiciel, dont le but est d'identifier tous les éléments constitutifs d'une infrastructure, d'un applicatif, etc, ainsi que les dépendances qui y sont liées, propriétaires ou open-source.
Une SBOM doit comprendre:
- Le nom du fournisseur (vendor, exemple: Debian)
- Le nom du composant (ex: linux kernel)
- La version du composant (ex: 6.12.86)
- La relation de dépendance (ex: Debian operating system)
- L'auteur des données SBOM (ex: Syft, Jean-Michel Sysadmin, etc)
- Toute information complémentaire permettant d'identifier le composant (optionnel)
- Et enfin l'horodatage: date et heure de création des données SBOM
Bien évidemment, on évite de générer une SBOM à la main, surtout si l'infrastructure à inventorier est de taille conséquente, on va plutôt utiliser des logiciels dédiés:
- Syft << on va s'en servir
- Tern
- CycloneDX Generator << lui aussi
- Distro2SBOM
- Jake
- sbom-rs
etc.
Attention, un SBOM n'est pas un détecteur de vulnérabilités. Il se contente de générer une liste des composants qu'il va stocker dans un artefact SBOM. Cet artefact peut ensuite être consommé par un détecteur de vulnérabilités comme Trivy, qui va nous fournir une liste des vulnérabilités présentes dans chaque composant inventorié par notre SBOM (images de conteneurs, etc).
Vulnérabilités, CVEs
Vous devez déjà le savoir, mais les vulnérabilités connues sont inventoriées dans un dictionnaire appelé CVE: Common Vulnerabilities and Exposures, qui a été créé par le MITRE à la fin des années 1990/début 2000. Actuellement le projet ayant perdu son financement du département de la sécurité des Etats-Unis (encore une décision complètement idiote de l'administration américaine actuelle), mais une coalition d'acteurs du milieu a permis de le financer jusqu'à mi-2026, c'est à dire maintenant. Le financement ultérieur a été sécurisé pour les années à venir (heureusement). En Europe, nous disposons d'une base similaire, EUVD.
La classification des vulnérabilités dans la base CVE utilise un score, CVSS (Common Vulnerabilities Scoring System), calculé en fonction de plusieurs facteurs: vulnérabilité locale, utilisable à distance, permettant une élévation de privilèges, permettant d'obtenir des informations sans authentification, etc.
Ce score CVSS est utile pour déterminer le niveau de risques d'une vulnérabilité:
- 0.0: aucun impact
- 0.1 à 3.9: risque faible
- 4.0 à 6.9: risque modéré
- 7 à 8.9: risque élevé
- 9 à 10: risque critique
Un score CVSS élevé indique en général une vulnérabilité potentiellement grave, surtout si elle est utilisable conjointement à d'autres CVEs de niveau de gravité différents (ex: combiner une CVE de type RCE avec une CVE de type élévation de privilège).
Scan de vulnérabilité
Afin de se prémunir de la présence de CVEs dans nos projets, nous allons donc utiliser des outils permettant de scanner nos artefacts (code source, images OCI de conteneurs, templates de machines virtuelles, etc) afin d'en recenser les potentielles vulnérabilités, et ce, idéalement à chaque étape de nos pipelines CI/CD.
Ces outils vont parcourir code source, dépendances, filesystems d'images de conteneurs, etc, et répertorier l'ensemble des vulnérabilités, idéalement avec leur score CVSS et leur identifiant CVE. Idéalement ces outils doivent aussi nous indiquer les moyens de remédiation nécessaires à soit l'élimination soit la mitigation de ces vulnérabilités (ex: CVE critique dans le paquet glib2 version 2.74.6-2+deb12u6, corrigée avec la version 2.74.6-2+deb12u8)
On peut citer plusieurs outils open-source:
- Aqua Security Trivy <-on utilisera celui là dans la suite du module
- Greenbone OpenVAS
- Google osv-scanner
- et bien d'autres, comme dockle (que nous utiliserons)

Ces outils peuvent analyser directement nos artefacts afin d'y trouver de potentielles vulnérabilités, mais sont aussi capables, en général, de "consommer" une SBOM pour lister les composants potentiellement vulnérables inventoriés dans la Software Bill Of Materials. Ils sont aussi capables de remonter la présence de secrets non chiffrés ou hardcodés dans nos artefacts. Certains outils comme DockLE vont plutôt nous orienter vers les bonnes pratiques concernant nos images docker (mode non-privilégié, "faire le ménage" dans le cache du gestionnaire de paquets, etc)
Gestion des secrets
Il est important qu'aucun secret ne soit accessible en clair dans les artefacts composant notre infrastructure. Les secrets doivent donc être soit chiffrés au repos, soit stockés dans une vault (un coffre-fort, donc), et être rendus accessibles uniquement lors de la phase d'exécution (runtime).
Pour cela, on dispose de plusieurs outils (liste non exhaustive!):
- Hashicorp Vault: une référence dans le domaine, développée par les créateurs de Nomad, Terraform et Packer, entre autres.
- Ansible Vault: le coffre-fort intégré à Ansible, la solution de gestion de configuration bien connue appartenant à IBM (et avant son rachat par IBM, à RedHat, qui l'avait acheté en 2012)
- SecureOPs (SOPS) et Kubernetes Secure OPs (KSOPS): une solution développée par la Mozilla Foundation (l'éditeur de Firefox), pouvant utiliser GPG, AES, etc pour le chiffrement inline de nos secrets.
- GPG: Gnu Privacy Guard, qui va nous permettre de chiffrer nos secrets, fichiers d'environnement, etc, avec les clefs publiques des personnes et comptes de service autorisés, et de les déchiffrer avec notre clef privée. GPG reste une solution efficace pour des projets et équipes de taille raisonnable, cependant il faut bien veiller à régénérer ses secrets, par exemple en cas d'arrivée d'un nouveau collaborateur dans l'équipe, ou en cas de départ. De même, il est important de faire attention à l'expiration des clefs GPG en question.
Avec tout ça, il n'y a pas de raison que vos dépôts git contiennent des secrets en clair et hardcodés!
Durcissement
L'ensemble de ces outils va nous permettre de progressivement durcir nos artefacts. On commencera en général par les Quick Wins (corrections nécessitant moins d'une heure de travail) pour progressivement avancer vers les sujets plus complexes (refonte de code, etc). A terme, la sécurité doit être intégrée dans chaque étape de chaque projet, et ne plus être un questionnement "après-coup" (lire: quand c'est en prod)
Exemple d'un pipeline
Un de vos développeurs vient de pusher (ou merger) sur une branche git spécifique, ce qui déclenche notre pipeline CI/CD.
La première étape va être le scan SAST du code, afin de s'assurer qu'aucune vulnérabilité n'a été ajoutée. Si une vulnérabilité est découverte dans le code, le build est interrompu et une alerte est générée.
Si la première étape est concluante, on va ensuite lancer une analyse des dépendances de notre logiciel (SCA), afin de vérifier qu'une dépendance (existante ou ajoutée) n'ouvre pas la porte à une potentielle vulnérabilité. Là aussi, en cas de problème, on interrompt le build, et on génère une alerte.
On va ensuite scanner nos recettes IaC, avec des outils comme tfsec, checkov, etc, et là aussi interrompre le build si un problème est remonté.
On passe ensuite au build de notre conteneur. Un fois buildé, l'image générée va être analysée, par exemple par Trivy. Si tous les tests sont OK, on va alors envoyer notre build dans notre environnement de staging/preprod, afin d'y appliquer nos tests DAST, par exemple avec des outils comme OWASP Zap.
Enfin, quand tout est validé, on peut - relativement - sereinement envoyer tout ça en prod, où nous allons pouvoir superviser et monitorer le bon fonctionnement de notre applicatif.
Les cinq métriques essentielles de l'approche DevSecOps
- Le MTTD: Mean Time to Detect, c'est le temps moyen de détection d'une faille. On le veut le plus court possible
 (<24h)
- Le MTTR: Mean Time to Remediate, c'est le temps moyen de correction d'une faille. Lui aussi, on le veut le plus court possible lui aussi (<7 jours, mais idéalement <48h)
- Le Taux de détection par étape: On veut détecter le maximum de failles/erreurs/etc durant la CI, pas en production!
- Le Taux de faux positifs: le bruit de fond. Le risque étant que si nos systèmes en place génèrent trop de faux positifs, on va finir par ignorer les alertes, au risque de laisser passer de vraies vulnérabilités!
- La couverture de scan, qui représente la métrique de ce qui est analysé par nos systèmes: code, dépendances, images de conteneurs, etc. Idéalement on tendra vers 100% à terme
TP-1: Découverte des outils syft, CycloneDX Generator, Trivy, dockle
Installation
Note concernant les images docker: en général on évite d'utiliser le tag latest, mais pour le TP ce sera suffisant
Premièrement, sur une VM Debian Stable:
sudo apt update
sudo apt dist-upgrade
sudo apt install docker.io docker-compose
# si votre utilisateur debian s'appelle patrick:
sudo usermod -aG docker patrick
On va ensuite installer nos différents applicatifs. Concernant Syft, on utilisera l'image docker officielle, les autres utilitaires vont être installés manuellement ou via le gestionnaire de paquets:
docker pull anchore/syft:latest
# On teste que ça fonctionne :)
docker run -it --rm anchore/syft alpine:latest
 ✔ Parsed image                    sha256:3cb067eab609612d81b4d82ff8ad71d73482bb3059a87b642d7e14f0ed659c
 ✔ Cataloged contents                  4d889c14e7d5a73929ab00be2ef8ff22437e7cbc545931e52554a7b00e123d8b
   ├── ✔ Packages                        [16 packages]
   ├── ✔ File metadata                   [79 locations]
   ├── ✔ File digests                    [79 files]
NAME                    VERSION      TYPE
alpine-baselayout       3.7.2-r0     apk
alpine-baselayout-data  3.7.2-r0     apk
alpine-keys             2.6-r0       apk
alpine-release          3.23.4-r0    apk
apk-tools               3.0.6-r0     apk
busybox                 1.37.0-r30   apk
busybox-binsh           1.37.0-r30   apk
ca-certificates-bundle  20260413-r0  apk
libapk                  3.0.6-r0     apk
libcrypto3              3.5.6-r0     apk
libssl3                 3.5.6-r0     apk
musl                    1.2.5-r23    apk
musl-utils              1.2.5-r23    apk
scanelf                 1.3.8-r2     apk
ssl_client              1.37.0-r30   apk
zlib                    1.3.2-r0     apk
Oui, Alpine par défaut, c'est light, très très light 
Au tour de deux outils de CycloneDX: cdx-audit et cdxgen:
mkdir cdx
cd cdx
#cdx-audit
VERSION="v12.3.1"
ASSET="cdx-audit-linux-amd64"
BASE_URL="https://github.com/cdxgen/cdxgen/releases/download/${VERSION}"
curl -fsSLO "${BASE_URL}/${ASSET}"
curl -fsSLO "${BASE_URL}/${ASSET}.sha256"
sha256sum -c "${ASSET}.sha256"
chmod +x "${ASSET}"
./"${ASSET}" --help

#cdxgen
VERSION="v12.3.1"
ASSET="cdxgen-linux-amd64"
BASE_URL="https://github.com/cdxgen/cdxgen/releases/download/${VERSION}"
curl -fsSLO "${BASE_URL}/${ASSET}"
curl -fsSLO "${BASE_URL}/${ASSET}.sha256"
sha256sum -c "${ASSET}.sha256"
chmod +x "${ASSET}"
./"${ASSET}" --help
# On teste:
./cdxgen-linux-amd64 -t docker alpine:latest
./cdx-audit-linux-amd64 --bom ./bom.json
CycloneDX est capable d'analyser un nombre important de langages, formats d'image, etc:
https://cdxgen.github.io/cdxgen/#/PROJECT_TYPES
DockLE:
VERSION=$(
 curl --silent "https://api.github.com/repos/goodwithtech/dockle/releases/latest" | \
 grep '"tag_name":' | \
 sed -E 's/.*"v([^"]+)".*/\1/' \
) && curl -L -o dockle.deb https://github.com/goodwithtech/dockle/releases/download/v${VERSION}/dockle_${VERSION}_Linux-64bit.deb

# et on l'installe via dpkg:
sudo dpkg -i dockle.deb
dockle alpine:latest
WARN    - CIS-DI-0001: Create a user for the container
        * Last user should not be root
WARN    - DKL-DI-0006: Avoid latest tag
        * Avoid 'latest' tag
INFO    - CIS-DI-0005: Enable Content trust for Docker
        * export DOCKER_CONTENT_TRUST=1 before docker pull/build
INFO    - CIS-DI-0006: Add HEALTHCHECK instruction to the container image
        * not found HEALTHCHECK statement
DockLE va nous permettre de construire des images Docker/OCI respectant les bonnes pratiques en identifiant les oublis et erreurs dans nos dockerfiles.
Enfin, Trivy:
docker pull aquasec/trivy:latest
# on teste:
mkdir trivycache
docker run -v /var/run/docker.sock:/var/run/docker.sock -v ./trivycache:/root/.cache/ aquasec/trivy:latest image alpine:latest
[...snip...]
2026-05-17T12:01:27Z    INFO    [alpine] Detecting vulnerabilities...   os_version="3.23" repository="3.23" pkg_num=16
2026-05-17T12:01:27Z    INFO    Number of language-specific files       num=0

Report Summary

┌───────────────────────────────┬────────┬─────────────────┬─────────┐
│            Target             │  Type  │ Vulnerabilities │ Secrets │
├───────────────────────────────┼────────┼─────────────────┼─────────┤
│ alpine:latest (alpine 3.23.4) │ alpine │        0        │    -    │
└───────────────────────────────┴────────┴─────────────────┴─────────┘
Legend:
- '-': Not scanned
- '0': Clean (no security findings detected)
Trivy est capable non seulement d'analyser vos images de conteneur OCI, mais aussi, par exemple, de scanner vos plans terraform:
docker run -v /var/run/docker.sock:/var/run/docker.sock -v ./trivycache:/root/.cache/ -v ./mon-projet-terraform:/mon-projet-terraform aquasec/trivy:latest config /mon-projet-terraform
2026-05-25T11:32:01Z    INFO    [misconfig] Misconfiguration scanning is enabled
2026-05-25T11:32:01Z    INFO    [checks-client] Need to update the checks bundle
2026-05-25T11:32:01Z    INFO    [checks-client] Downloading the checks bundle...
234.65 KiB / 234.65 KiB [--------------------------------------------------------->] 100.00% ? p/s ?234.65 KiB / 234.65 KiB [----------------------------------------------] 100.00% 37.23 MiB p/s 200ms2026-05-25T11:32:02Z    INFO    [terraform scanner] Scanning root module        file_path="."
2026-05-25T11:32:02Z    INFO    Detected config files   num=1

Report Summary

┌────────┬───────────┬───────────────────┐
│ Target │   Type    │ Misconfigurations │
├────────┼───────────┼───────────────────┤
│ .      │ terraform │         0         │
└────────┴───────────┴───────────────────┘
Legend:
- '-': Not scanned
- '0': Clean (no security findings detected)
Activité 1: Testons une image connue pour présenter des vulnérabilités
En l'occurence, une version récente mais pas trop©️ de Wordpress:
docker pull wordpress:6.9.1-php8.4-apache
On va donc commencer par:
- Se faire une idée de la SBOM via Syft
- Créer la SBOM de cette image via CDX
- Tester cette image via DockLE
- Puis la tester avec Trivy
Que remarquez-vous? Ce résultat vous semble-t-il raisonnable? Comparez avec l'image de base Debian trixie.
Activité 2: Testez des images docker que vous avez créées lors de votre cursus
(et j'en veux bien une ou deux pour tester de mon côté )
- Quelles seraient vos préconisations - si besoin - pour améliorer le niveau de sécurité de vos images docker personnelles?
TP-2: Harbor, SBOM et trivy intégré
Alors, on le voit bien, exécuter manuellement ce genre de scan à chaque fois qu'on rebuilde, par exemple, une image de conteneur, ça va devenir rapidement pénible.
De même, notre applicatif peut aussi reposer sur des éléments externes en provenance d'éditeurs bien connus, comme par exemple les images officielles de conteneurs PostgreSQL, MariaDB, nginx, Apache2, Redis ou Valkey, etc.
On peut donc vouloir analyser aussi ces images - rien ne nous dit qu'un éditeur, même reconnu, ne va pas laisser passer quelque chose. De plus, afin de ne pas déclencher de rate-limit depuis de gros dépôts officiels comme le Docker Hub, on voudra probablement récupérer les images dont nous avons besoin à intervalle régulier, et les distribuer ensuite depuis notre dépôt de conteneur local. Dès lors, on voudra aussi tester ces images à intervalle régulier afin d'être sûrs de ne pas introduire de potentielle vulnérabilité.
Idéalement, notre dépôt de conteneurs devrait donc nous permettre de:
- Générer la SBOM d'une image
- Utiliser un scanner de vulnérabilités comme Trivy
Eh bien, on a de la chance, c'est exactement ce qu'Harbor fait
Procédure d'installation: Debian, K3S, Helm, Harbor, Profit 
On va se créer une VM Debian 13 classique, idéalement 2vCPUs, 4Go de RAM (si possible 6Go), 30Go de disque, SANS interface graphique!
On va ensuite installer K3S, une distribution allégée de Kubernetes. Nous n'utiliserons qu'une seule machine, qui fonctionnera à la fois comme control-plane et comme worker:
curl -fsL https://get.k3s.io | sh -
Oui, c'est moche curl | shell, je sais.
On va ensuite rapidement se faciliter la vie pour la suite en copiant le fichier kubeconfig et en modifiant un élément de configuration:
mkdir .kube
sudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/config
sudo chown -R 1000:1000 .kube
echo "export KUBECONFIG=~/.kube/config" >> ~/.bashrc
source .bashrc
kubectl get nodes
NAME                               STATUS   ROLES                AGE   VERSION
k3s-lab-controlplane-xmnrd-pcr97   Ready    control-plane,etcd   14d   v1.35.4+k3s1
On va ensuite installer Helm (et oui, on va encore piper un script shell venu d'internet dans un shell sur notre VM. C'est mal, je sais):
curl -fsSL -o get_helm.sh https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-4
chmod 700 get_helm.sh
./get_helm.sh
Helm est une sorte de gestionnaire de paquets (en grossissant beaucoup le trait) pour Kubernetes. Il va nous permettre de facilement déployer Harbor sans devoir écrire trop de YAML: on modifiera juste un fichier values.yaml qui va nous permettre d'adapter la configuration d'Harbor à notre setup.
database:
  internal:
    affinity: {}
    automountServiceAccountToken: false
    extrInitContainers: []
    extraEnvVars: []
    image:
      repository: docker.io/goharbor/harbor-db
      tag: v2.15.0
    initContainer:
      migrator: {}
      permissions: {}
    livenessProbe:
      failureThreshold: 3
      initialDelaySeconds: 300
      periodSeconds: 10
      successThreshold: 1
      timeoutSeconds: 1
    nodeSelector: {}
    password: this-is-a-good-password
    priorityClassName: null
    readinessProbe:
      failureThreshold: 3
      initialDelaySeconds: 1
      periodSeconds: 10
      successThreshold: 1
      timeoutSeconds: 1
    serviceAccountName: ''
    shmSizeLimit: 512Mi
    tolerations: []
  maxIdleConns: 100
  maxOpenConns: 900
  podAnnotations: {}
  podLabels: {}
  type: internal
expose:
  ingress:
    annotations:
      ingress.kubernetes.io/proxy-body-size: '0'
      ingress.kubernetes.io/ssl-redirect: 'true'
      nginx.ingress.kubernetes.io/proxy-body-size: null
      nginx.ingress.kubernetes.io/ssl-redirect: null
      #cert-manager.io/cluster-issuer: letsencrypt-issuer
      #cert-manager.io/private-key-algorithm: ECDSA
      #cert-manager.io/private-key-size: '384'
    className: traefik
    controller: default
    hosts:
      core: harbor.domain.tld
    kubeVersionOverride: ''
    labels: {}
  type: ingress
externalURL: https://harbor.domain.tld
harborAdminPassword: Harbor12345
imagePullPolicy: IfNotPresent
imagePullSecrets: null
logLevel: info
persistence:
  enabled: true
  imageChartStorage:
    filesystem:
      rootdirectory: /storage
    type: filesystem
  persistentVolumeClaim:
    database:
      accessMode: ReadWriteOnce
      annotations: {}
      existingClaim: ''
      size: 10Gi
      storageClass: local-path
      subPath: ''
    jobservice:
      jobLog:
        accessMode: ReadWriteOnce
        annotations: {}
        existingClaim: ''
        size: 5Gi
        storageClass: local-path
        subPath: ''
    redis:
      accessMode: ReadWriteOnce
      annotations: {}
      existingClaim: ''
      size: 1Gi
      storageClass: local-path
      subPath: ''
    registry:
      accessMode: ReadWriteOnce
      annotations: {}
      existingClaim: ''
      size: 20Gi
      storageClass: local-path
      subPath: ''
    trivy:
      accessMode: ReadWriteOnce
      annotations: {}
      existingClaim: ''
      size: 5Gi
      storageClass: local-path
      subPath: ''
  resourcePolicy: keep
secretKey: this-is-a-secure-key
Bien évidemment, si on regarde ce fichier, on voit que quelques secrets s'y "trimballent", ce qui signifie qu'on voudrait soit peupler ces secrets depuis des secrets Kubernetes précédemment créés de façon sécurisée, soit chiffrer ce fichier au repos via GPG, SOPS, ou peupler ces secrets depuis une Vault.
Normalement, on devrait tomber sur quelque chose du style une fois identifiés (on va voir ensuite si le certificat autosigné pose souci pour push des images sur ce dépôt):
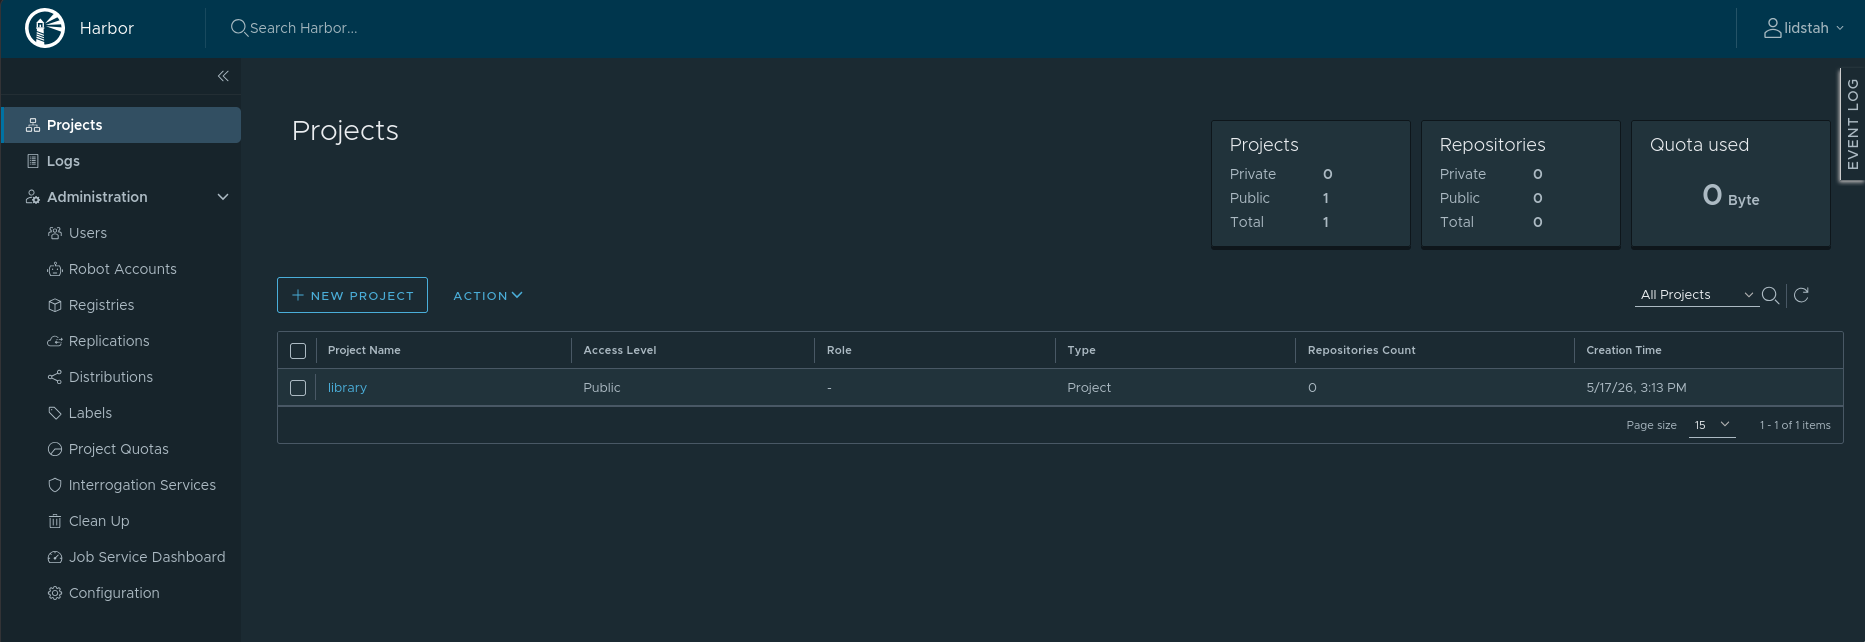 On va se créer un "robot account", qui va nous servir à pusher nos images de conteneurs sur notre projet (que nous aurons précedemment créés).
TP-3: Durcissement d'une image
On va se créer une image avec nginx (ou ultérieure), qui va héberger un petit jeu web, et volontairement, nous allons laisser des "petits" un peu partout, et voir ce que nos outils nous remontent:
FROM alpine:latest

RUN apk update
RUN apk upgrade
RUN apk add git nginx

RUN git clone https://github.com/Werkstattl/quick-dungeon-crawler-rpg-od /usr/share/nginx/html
COPY ./default.conf /etc/nginx/http.d/default.conf

CMD ["/usr/sbin/nginx", "-g", "daemon off;"]
Le contenu de default.conf:
server {
    listen       80;
    listen  [::]:80;
    server_name  localhost;

    location / {
        root   /usr/share/nginx/html;
        index  index.html index.htm;
    }

    error_page   500 502 503 504  /50x.html;
    location = /50x.html {
        root   /usr/share/nginx/html;
    }
}
Comme vous le voyez déjà probablement, on a beaucoup, beaucoup de soucis dans cette image:
- s'exécute en root
- on ne nettoie rien derrière
- probablement d'autres choses
On va donc utiliser les différents outils dont nous disposons pour:
- Sortir une SBOM simple
- obtenir des préconisations quant à notre dockerfile
- inventorier les CVEs présentes (ou pas) dans notre image
Et corriger tout ça!
Maintenant, reconstruisons une image identique, mais en partant d'une base debian:trixie. Comparons les résultats du SBOM et de Trivy.
Bonus: le faire tourner sur le petit "cluster" kube