title: Réseaux Informatiques: Bases
description: Câbles, Ethernet, TCP/IP, bases du routage, etc 
published: true
date: 2024-01-20T14:58:05.072Z
tags: basics, networking
editor: markdown
dateCreated: 2024-01-20T13:52:22.947Z
Historique
L'idée d'interconnecter des ordinateurs entre eux n'est pas nouvelle.
Dès 1961, Leonard Kleinrock introduisait la notion d'ARPANET dans son article "Information Flow in Large Communication Nets". Il faut savoir qu'à l'époque, le plus gros réseau de télécommunication existant était le réseau téléphonique, qui fonctionne par commutation de circuit (grâce à des relais), système qui était adapté au transfert de la voix à débit constant mais inadapté au transfert de données informatiques dont le débit, la taille et la latence doivent pouvoir varier dans le temps, et qui peuvent être envoyées et reçues de plusieurs machines à la fois. Leonard Kleinrock proposa alors d'utiliser, non plus de la commutation de circuit, mais la commutation de paquets dès 1961.
Grâce à son travail et au travail de nombreux autres chercheurs et chercheuses, dont, notamment, Paul Baran et Louis Pouzin (ingénieur français qui travaillait à l'époque au MIT, et qui participa en France au projet Cyclades de réseau ARPANET européen, qui fût malheureusement abandonné au profit de Transpac/x.25 "grâce" au lobbying de notre cher opérateur historique au nom d'agrume), les bases des protocoles réseaux encore utilisés de nos jours ont été posées.
Influencés par leurs prédecesseurs et notamment le travail de Louis Pouzin, Vinton ("Vint") Cerf et Robert "Bob" Kahn développèrent la suite des protocoles TCP/IP qui fût formalisée en 1973.
La toute première communication entre ordinateurs sur ARPANET (l'ancêtre d'Internet) a été effectuée le 29 Octobre 1969. Il s'agissait d'une connexion Telnet (l'ancêtre de SSH), utilisant pour la première fois un protocole réseau ancêtre de TCP/IP (TCP Over IP), NCP (Network Control Protocol, encore utilisé pour les liens PPP (Point to Point Protocol)).
Par la suite, de part l'évolution matérielle constante, les anciens Interface Message Processors, IMP (on retrouve de temps en temps cette dénomination) furent progressivement remplacés par les routeurs tels qu'on les connaît aujourd'hui. Développés à la fin des années 60 et pendant les années 70, ils restèrent le cœur d'ARPANET jusqu'en 1989.
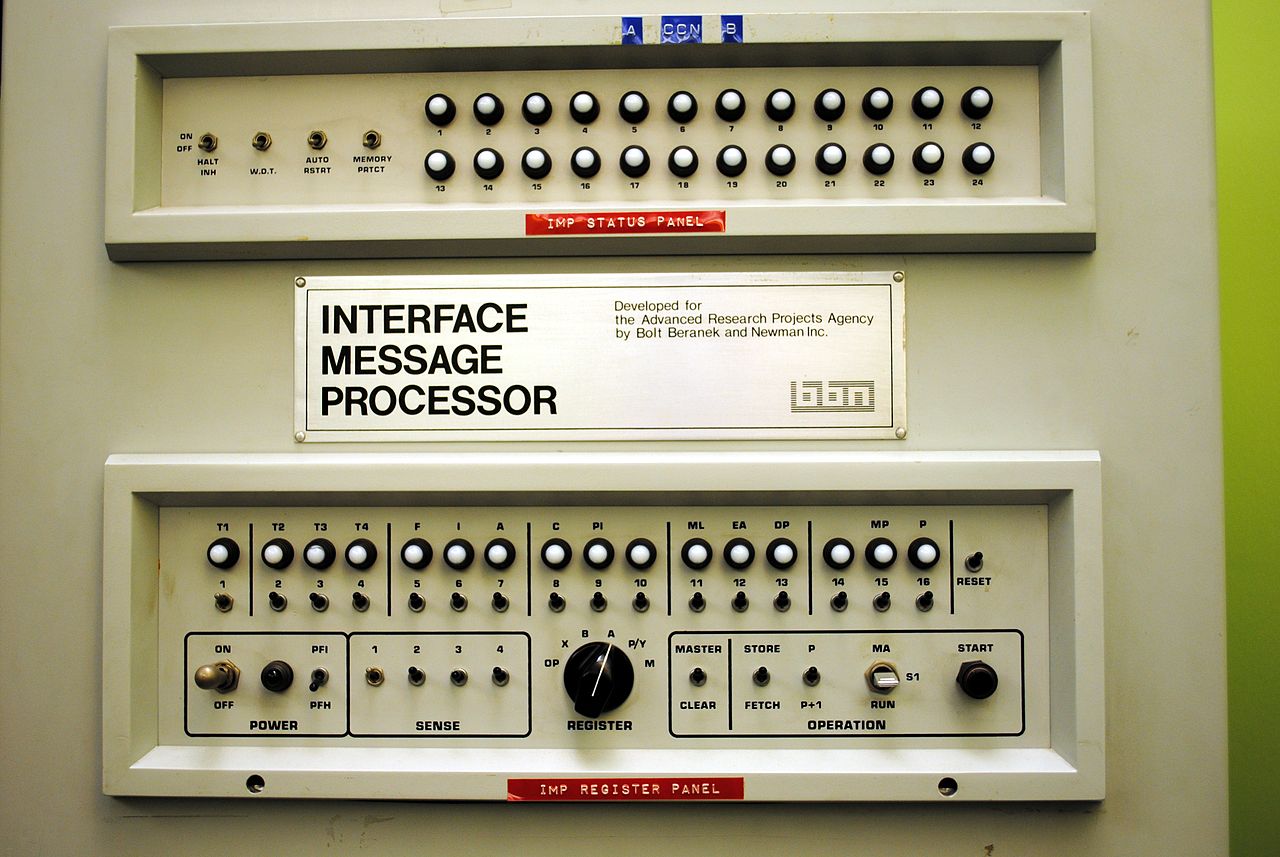
Un des premiers IMP, en 1969, assez... "rustique" (source: Wikipédia en), avec une bande passante phénoménale (pour l'époque) de 50 kilobits par seconde. Pour l'anecdote, le logiciel et le protocole de communication de ces machines sont décrits dans la RFC 1.
En 1980, Bill "Router Man" Yeager développe le premier routeur multi-protocoles à l'Université de Stanford. Il est à l'époque aidé de Len Bosack et Sandy Lerner, qui créeront d'ailleurs une petite PME du nom de Cisco.
Le tout premier routeur Cisco sorti en 1986. Nommé AGS pour Advanced Gateway Server, il supportait TCP/IP, PUP, entre autres protocoles. Il disposait déjà, à l'époque, d'une interface (FDDI) capable de supporter 100Mbps. Suivit l'AGS+, remplaçant le CPU Motorola 68020 (équivalent à un 386SX) de l'AGS par un 68040 nettement plus "costaud" (équivalent à un 486DX2):
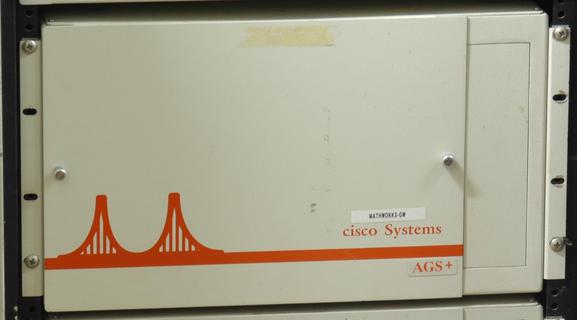
(source: rcsri.org (Retro-Computing Society of Rhode Island, Inc.))
Dans le même temps, apparaissaient les premiers commutateurs Ethernet 100Mbps (Grand Junction, 1993):
(source: rcsri.org (Retro-Computing Society of Rhode Island, Inc.))
Au fur et à mesure de l'évolution du réseau, sont apparus des modèles de routeurs de plus en plus compacts et de plus en plus puissants, avec des interfaces à 1Gbps, puis 10Gbps, etc. Les CPUs "classiques" utilisés dans les premiers routeurs sont maintenant aidés de circuits ASICs spécialisés (tout comme pour le minage de bitcoins :p). On peut citer les routeurs Cisco de la série ASR:
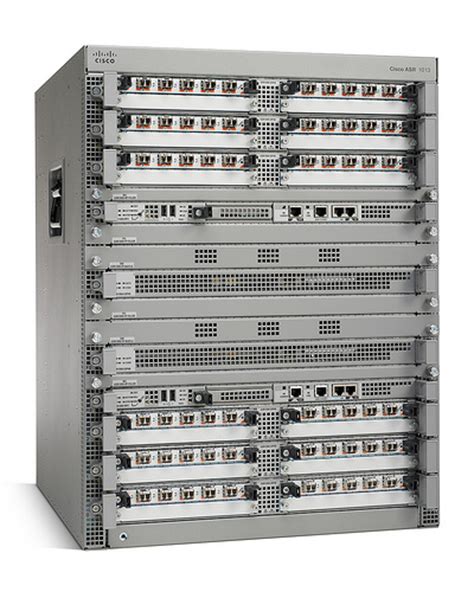
(source: Cisco)
De même, de nombreux concurrents sont apparus au fil du temps: Juniper, Mikrotik, Brocade, Allied Telesis, DLink (oui oui), etc, visant à la fois le marché d'entreprise et le marché PME/PMI voire particuliers (passionnés).
De plus, dans des environnements ne nécessitant pas des performances "ultimes" (et même là...), il est tout à fait possible d'utiliser des APUs ou des serveurs sous GNU/Linux ou BSD (FreeBSD pour les perfs, OpenBSD pour les parano... euh, la sécurité), et bénéficier de la syntaxe "Cisco" IOS via les logiciels Quagga ou FRR, qui est une surcouche aux différents daemons réseau disponibles (par exemple bgpd, ospfd, routed, etc) offrant une syntaxe et une CLI quasiment identiques à celle d'un routeur Cisco.
Supports du réseau
Qu'est-ce qu'un réseau?
Un réseau est l'interconnexion de deux ou plusieurs machines entre elles, dans le but de partager des données.
Un réseau est en général composé de différents ordinateurs, périphériques réseaux (routeurs, commutateurs, etc) qui vont communiquer entre eux à l'aide d'un ou plusieurs protocoles de communication.
On peut en distinguer deux types:
- Les réseaux /peer to peer/ où chaque ordinateur va posséder les mêmes fonctions que les autres membres du réseau (ex: bittorrent)
- Les réseaux client/serveur, où le client effectue des requêtes vers le(s) serveur(s) qui lui répond (ou pas :p)
Quelques exemples de services réseaux classiques:
- Services de fichiers (NFS, SMB/CIFS)
- Services d'authentification (LDAP, OIDC, etc)
- Services d'impression (le cauchemar :p)
- Services Web (pas vraiment besoin d'exemple dans ce cas )
- Serveurs de jeux vidéos
- Serveurs de Temps (NTP, Dave Mills (RIP
 ))
Catégories de réseaux
LAN: Local Area Network
Ce qu'on appelle un /réseau local/ est un réseau où les périphériques et noeuds du réseau sont interconnectés sur des distances relativement courtes (ce n'est pas toujours le cas, par exemple avec un CLAN mais c'est hors de notre périmètre de cours)
En règle générale, un LAN est controllé par une seule personne physique ou morale.
Ces réseaux utilisent en général le protocole Ethernet que nous détaillerons dans la suite du cours
MAN: Metropolitan Area Network
Il s'agit d'un réseau de taille largement supérieure à un LAN, en général à l'échelle d'une ville.
En règle générale ce genre de réseau est opéré par des entités gouvernementales ou des entreprises de grande taille (banques, assurances, etc) dont ils ont la propriété (ou louent l'infrastructure nécessaire à un prestataire de service (FAI professionnel, par exemple, dans le coin, Axione, Gigalis, Atlantic Networks, etc))
Sur Nantes, le réseau de l'Accoord interconnecte les ~50 centres socio-culturels et de loisirs de Nantes Métropole.
WAN: Wide Area Network
Un WAN est un réseau de taille quasi mondiale. Par exemple, le réseau de Cogent (2è transitaire mondial) est un WAN à lui tout seul car il couvre plusieurs continents et traverse plusieurs océans.
Le WAN que vous utilisez tous les jours s'appelle Internet (et est lui même l'interconnexion de dizaines de milliers de WAN, MAN et LANs)
WLAN: Wireless LAN
Il s'agit d'un /LAN/ sans fil
SAN: Storage Area Network
Un SAN connecte des serveurs à des périphériques de stockage de données (en général ce qu'on appelle des baies de disques), en utilisant des technologies comme Fibre Channel.
Ces baies de stockages utiliseront en général des protocoles de communications tels qu'iSCSI, iSCSI over Ethernet, etc, qui n'exposent pas des partages de fichiers mais des LUN (Logical Unit Number) exposant des /block devices/ qui vont se comporter comme des disques durs locaux non partitionnés/formatés.
Câbles réseaux, fibres optiques, cuivre, WiFi: moyens de transmission
Paire de fils de cuivre torsadés
Il s'agit d'un type de câble où les deux fils conducteurs sont torsadés (en mode scoubidou) afin de minimiser les effets de l'induction électromagnétique (Maxwell) et donc le bruit et le
crosstalk entre nos câbles de cuivre formant notre paire de cuivre:
C'est une méthode qui remonte à l'invention du téléphone par Alexander Graham Bell.
Câbles Ethernet
Types de blindage
Un câble ethernet est composé de quatre paires de fils de cuivre torsadés, et peut être blindé ou pas (oups). Les câbles blindés possèdent en général, en plus de l'âme du câble, un fil métallique supplémentaire, qui sert de drain de masse.
Afin, là encore, de limiter les interférences sur notre câble, il existe plusieurs types de blindage, ainsi qu'un type de câble non-blindé:
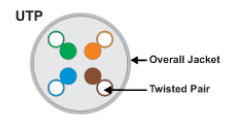
- U/UTP (/Unshielded Twisted Pair/): quatre paires de fils de cuivre couverts d'une couche de plastique coloré, l'ensemble étant recouvert d'une couche de plastique supplémentaire. Pas de blindage, pas de masse. On les utilisera principalement pour des connexions courtes, même si on leur préfèrera toujours un blindage simple:
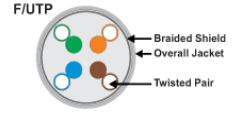
- F/UTP et S/UTP: Dans le cas d'un câble F/UTP (/Foiled over UTP/) une feuille métallique entoure nos quatre paires de cuivre. Dans le cas de S/UTP, il s'agit d'un treillis métallique, plus lourd, et plus cher.
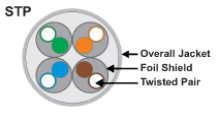
- STP ou U/FTP (/Unshielded Foiled Twisted Pair/): Ici, chaque paire de cuivre est entourée d'une feuille métallique.
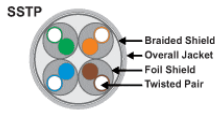
- SF/UTP ou SSTP (/Shielded Shielded Twisted Pair/): le top du top avec un prix au mètre défiant toute concurrence (sarcasm inside), chaque paire est recouverte d'une feuille métallique et l'ensemble est recouvert d'une feuille métallique supplémentaire.
Catégories de câbles Ethernet
Il existe 8 catégories de câbles Ethernet, la huitième étant encore en phase de standardisation. Chaque catégorie de câble spécifie:
- un rayon de courbure (bend radius) maximum. Au delà de ce rayon de courbure, les contraintes sur le câble pourrait entraîner la rupture d'une ou plusieurs paires torsadées et donc une dégradation du signal (et donc de la vitesse)
- Une longueur maximum de câble, par exemple 100 mètres pour du cat 5e.
Quelques catégories de câbles:
Cat3 (10Mbps)
Il s'agissait d'un câble ethernet avec au minimum 4 fils (deux paires torsadées). Il n'est plus utilisé de nos jours. Cependant, un câble Ethernet abîmé peut entraîner une négociation à 10Mbps, par exemple.
Cat5 et Cat5e (100Mbps (Fast Ethernet) et 1Gbps (Gigabit Ethernet))
- Cat5: Fréquence 100MHz, jusqu'à 1Gbps de bande passante
- Cat5e: similaire au cat5 mais avec de meilleurs tests de qualité
Mais il y a mieux, les câbles Cat6 et supérieurs:
Cat6 et supérieurs (jusqu'à 10Gbps (cat6, 6A, 7))
Jusqu'à 10Gbps de bande passante, jusqu'à 100m avec les caractéristiques suivantes:
| Classe | Catégorie | Type de blindage | BP | Connecteur |
|---|---|---|---|---|
| E | 6 | FTP | 500MHz | RJ45 |
| Ea | 6a | UTP | 500MHz | RJ45 |
| F | 7 | SSTP | 600MHz | GG45 |
Connecteurs, outils de sertissage
Pour sertir un câble Ethernet cat5(e) on utilisera:
- Deux embouts RJ45 (un de chaque côté) blindés ou pas:
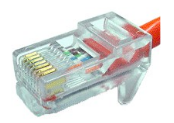
- Une pince de sertissage:
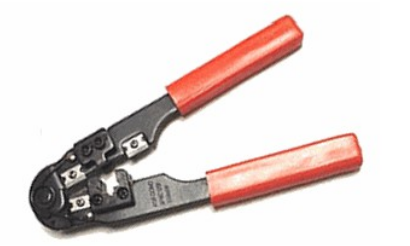
Un câble Cat6 est plus difficile à sertir: le diamètre du câble étant plus important on est obligé de positionner les brins en quinquonce via un petit embout plastifié qu'on insèrera ensuite dans le connecteur RJ45. En un mot comme en cent, c'est une galère sans nom
Câbles droits, câbles croisés, normes de câblage
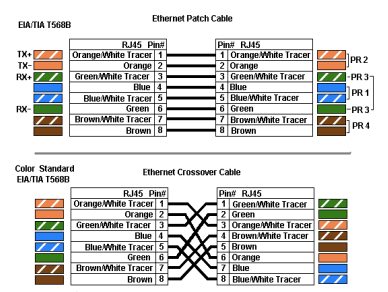
Il existe deux types de câbles: droits et croisés.
La majorité des interfaces réseau sont désormais capables de négocier automatiquement le mode de transmission quel que soit le câble à une exception près: on utilisera un câble croisé pour connecter un ordinateur directement à un routeur. (et encore...)
Embout RJ45 et numérotage des connecteurs:
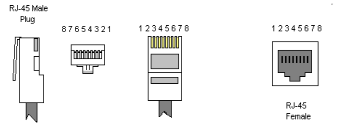
Il existe deux normes de câblage:
- T568A:
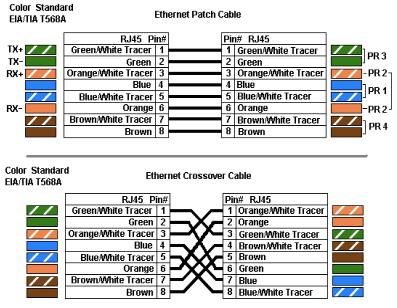
- T568B
Fibres optiques
Un câble de fibre optique est constitué:
- de plusieurs fibres de verre
- entourées de PVC
- recouvert de fibres d'aramide (un polyamide synthétique), qui vont
compenser les contraintes (traction, etc) subies par le câble afin
de préserver le coeur. - le tout recouvert d'une couche de PVC.
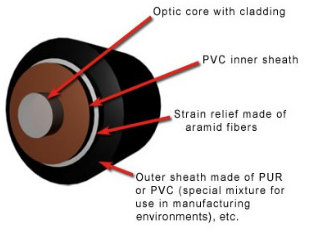
Lorsqu'une fibre optique est connectée à deux périphériques réseau configurés et fonctionnels, on dit que la fibre est /éclairée/.
Il existe deux types de fibres optiques, en fonction des besoins (distance et longueur notamment):
Fibre monomode
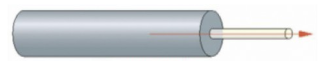
Une fibre monomode ne supporte qu'un mode de propagation de la lumière à l'intérieur de la fibre optique.
Ces fibres sont en général utilisées dans les communications longue distance.
Elles utilisent en général d'authentiques lasers pour la transmission de l'information.
Fibre multimode
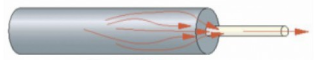
Une fibre multimode supporte plusieurs chemins et modes de propagation. Elles ont un diamètre supérieur à une fibre monomode et sont utilisées pour des communications de courte distance (jusqu'à 1km 500m) et utilisent généralement des LEDs pour la transmission de l'information.
Interfaces réseaux Fibre Optique
On peut citer plusieurs types d'interfaces réseaux dédiées à la fibre optique:
- L'ancien format GBIC (1 Gbps)
- SFP (mini-GBIC), SFP+ (10 Gbps) (/Small Form-factor Pluggable/)
Je vous recommande chaudement la lecture de l'article Wikipédia correspondant:
https://fr.wikipedia.org/wiki/Small_form-factor_pluggable ) - XFP (10Gbps)
- QSFP (40Gbps)
- CFP (100Gbps)
*Là encore je vous recommande la lecture de l'article Wikipédia correspondant:
https://fr.wikipedia.org/wiki/XFP *
Un périphérique convertissant un lien fibre optique vers un lien RJ45
(Cat5 ou plus) s'appelle un transceiver.
WiFi
Un réseau sans-fil fait référence à un réseau qui n'est pas connecté au moyen de câbles.
Ces technologies sont basées sur l'ensemble de normes IEEE 802.11 (b/g/n/ac, Wifi6, etc, sur des fréquences de 2.4 et 5GHz suivant la norme et l'équipement)
Adaptateurs et cartes d'accès
On les trouve sous beaucoup de formats: cartes PCI/PCIe/PCMCIA (old school ), clefs USB, intégrés à la carte-mère, etc.
Ils permettent à un ordinateur ou autre périphérique réseau de se connecter à un WLAN.
Points d'accès
Un point d'accès sans-fil (WAP, /Wireless Access Point/) est un périphérique permettant aux périphériques sans fil de se connecter à un réseau câblé en utilisant la norme WiFi, Bluetooth ou tout autre standard correspondant.
Topologie des réseaux
On distingue plusieurs topologies de réseaux, certaines plus utilisées que d'autres, certaines réminiscentes du passé, d'autres plus ou moins adaptée à certains besoins.
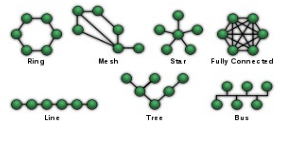
Bus
- Un seul câble et un noeud par machine
- Le signal voyage dans les deux directions, en passant par toutes les machines connectées, jusqu'à ce qu'il trouve le destinataire
- Chaque machine analyse la trame/le paquet et accepte ou fait suivre les données en fonction de l'adresse de destination
Anneau (Ring)
- Les données travers l'anneau dans une seule direction, chaque périphérique agissant comme un répéteur
- Le réseau est dépendant de la capacité du signal à "faire le tour" de l'anneau
- Chaque machine analyse la trame/le paquet et accepte ou fait suivre les données en fonction de l'adresse de destination
Etoile (Star)
- Chaque noeud du réseau est connecté à un hub ou commutateur (switch) central
- Il est facile d'ajouter de nouveaux noeuds au réseau
- Le commutateur/hub constitue un /SPOF/ (Single Point Of Failure)
- Typiquement le type de réseau qu'on rencontre dans un LAN
Pleinement connecté (Fully connected)
- Pour un réseau de /n/ machines, chaque machine dispose de /n-1/ connexions
- En règle générale, trop cher et complexe pour des réseaux normaux
Mesh
- Typiquement, Internet est un réseau Mesh.
- Dans un réseau Mesh, un même noeud peut être accessible par plusieurs routes (résilience).
- Dès lors, on va avoir besoin d'un protocole de routage dynamique pour annoncer les nouvelles routes au reste du réseau.
Le modèle OSI et le modèle TCP/IP
Les couches OSI (/Open Systems Initiative/)
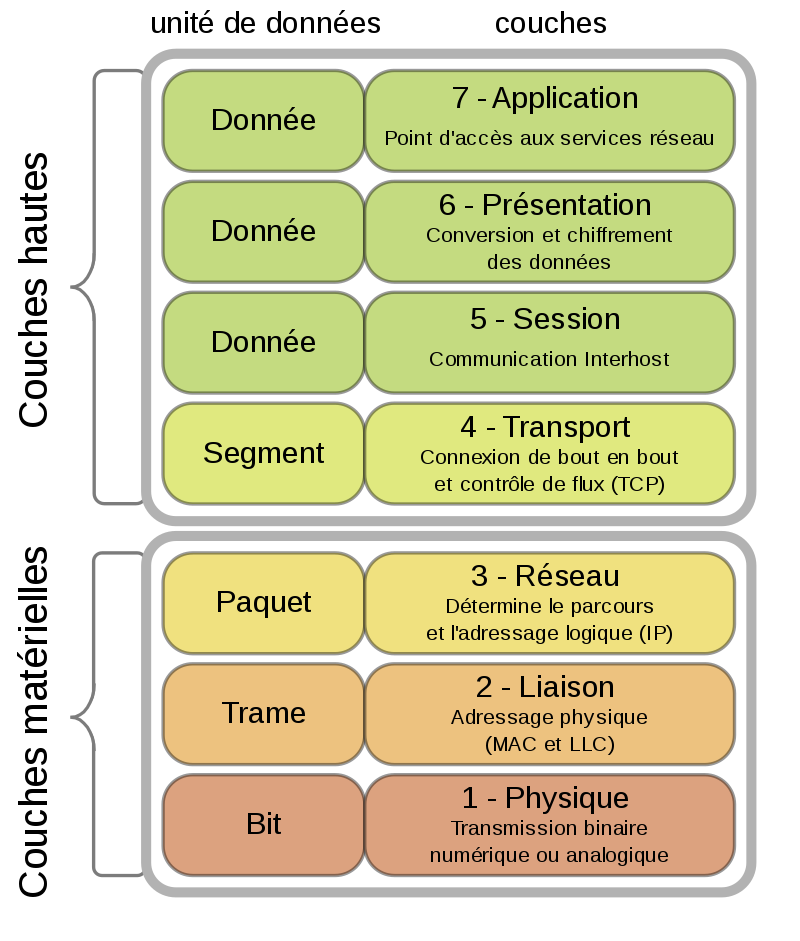
- Physique: ADSL, câble RJ45, ondes électromagnétiques, etc
- Liaison: Ethernet, WiFi, PPP, ARP, ATM, etc (commutateurs a.k.a /switches/). On parle de /frame/ ou /trame/
- Réseau: ARP (oui oui), IPv4, IPv6, ICMP, IGMP, OSPF... (routeurs), on parle de /paquets/
- Transport: TCP, UDP, OSPF, etc, on parle de /segments/
- Session: Netbios (lol)
- Présentation: HTML, XML, SMB, NFS
- Application: NNTP, DNS, SMTP, POP3, IMAP...
Si les deux premières couches (et dans une moindre mesure la troisième) fonctionnent via une combinaison matérielle et logicielle, toutes les couches supérieures sont implémentées de façon purement logicielle.
Les couches du modèle TCP/IP (/Transmission Control Protocol/ et /Internet Protocol/)
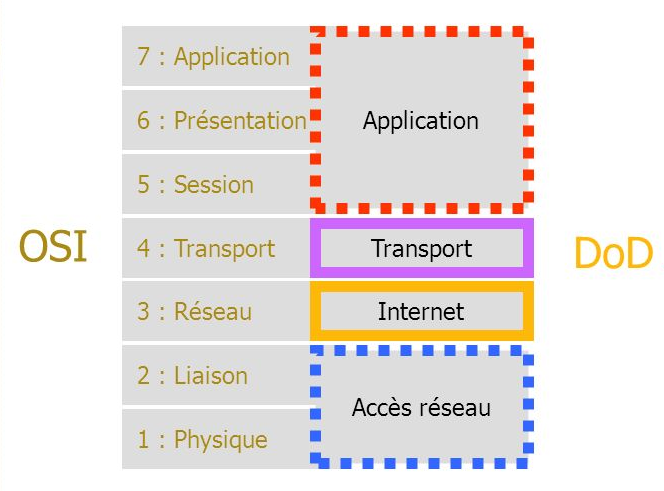
- Accès: câble RJ45+Ethernet, ARP, etc
- Réseau: IPv4, IPv6, ICMP, IGMP...
- Transport: TCP, UDP...
- Application: le reste
Composants du réseau
Répéteurs
Un répéteur est un périphérique électronique qui, lorsqu'il reçoit un signal, le "nettoie" de son bruit, le régénère, et le retransmet.
On peut prendre comme exemple les répéteurs Ethernet, qui permettent de créer des liaisons Ethernet de plus de 100 mètres via des câbles Ethernet classiques, ou les répéteurs WiFi qui permettent d'augmenter significativement la surface couverte par un réseau WiFi.
Un répéteur travaille sur la première couche - Physique - du modèle OSI.
Hubs
On ne les rencontre plus que rarement, voire plus du tout. Un hub:
- partage sa bande passante avec tous les périphériques connectés. Ainsi, un hub 100Mbps possède une bande passante totale de 100Mbps partagée entre les périphériques qui y sont connectés.
- Chaque paquet reçu est retransmis à tous ses ports. Ce qui entraîne pas mal de collisions de paquets.
- L'intérêt en était principalement le prix.
Un hub travaille principalement sur la couche 1 du modèle OSI, mais les hubs plus modernes gérant les collisions de paquets travaillent aussi sur la couche 2 (Liaison) du modèle OSI.
Commutateurs (aka switches)
Un switch diffère d'un hub dans le sens où il n'envoit les trames reçues qu'aux ports nécessaires. Il possède une table interne liant port et adresse MAC du périphérique connecté à ce port, et donc décide du chemin d'une trame reçue sur cette base de relation port/adresse MAC. Un switch crée un domaine de collision de paquets séparé pour chaque port du switch.
Une autre différence avec un Hub est que la bande passante n'est plus partagée. Ainsi, un port 1Gbps d'un switch dispose bien d'1 gigabits par seconde de bande passante (soit ~120Mo/s).
Un switch fonctionne sur la couche Liaison (2) du modèle OSI. Certains modèles proposent des fonctionnalités appartenant à la couche 3 du modèle OSI (serveur DHCP, voire parfois options simples de routage).
On peut aussi différencier deux types de commutateurs:
- Les switches non-manageables (mais peuvent supporter le protocole 802.1q (VLANs))
- Les switches manageables via une interface en ligne de commande, voire une interface Web. Ces switches permettent en général de créer des VLAN (Virtual LAN, protocole IEEE 802.1Q, aussi appelé /dot1q/) permettant d'isoler, par exemple, le trafic et les ressources réseau de la compta du trafic et des ressources réseau de la direction, etc.
Notes sur les VLANs
Un VLAN (Virtual LAN) est un domaine Ethernet "virtuel", identifié par un tag correspondant au numéro du VLAN. Il s'agit de la norme 802.1q.
Tout réseau d'entreprise sérieux doit être "découpé" en VLANs, tout simplement pour isoler des sous-réseaux les uns des autres, les communications entre ces sous-réseaux étant assurées par des routeurs, suivant les besoins et règles de sécurité désirés par l'entreprise.
Par exemple, on pourra mettre en place un sous-réseau accessible via Wifi pour permettre aux prestataires/clients/etc de l'entreprise d'accéder à Internet sans pouvoir accéder aux autres sous-réseaux de l'entreprise. Dans ce cas, on dédiera un VLAN à ce sous-réseau, et on mettra en place un système de contrôle d'accès réseau pour ne donner l'accès à ce réseau qu'au personnel autorisé, via un mécanisme de voucher par exemple.
Côté commutateur, la configuration d'un VLAN s'effectue en assignant les ports voulus à un VLAN, ou plusieurs VLANs, et en indiquant si c'est le switch qui "tagge" le VLAN sur ce port, ou si c'est le périphérique connecté au port qui tagge le (ou les) vlans autorisés.
En règle générale:
- les postes de travail utilisateurs n'ont en général aucune notion de VLAN, c'est donc le switch qui taggera le VLAN
- Les routeurs ou serveurs, eux, peuvent vouloir accéder à plusieurs VLANs, et ce sera donc eux qui taggeront les VLANs auxquels ils ont accès
- Enfin, il existe des modes (Trunk ou ACCESS suivant le fournisseur du switch) permettant à un équipement réseau d'accéder à tous les VLANs - c'est là aussi à l'équipement de tagger les VLANs désirés.
Le protocole le plus connu est 802.1Q, qui permet de gérer 4096 VLANs (4094 effectifs, deux étant réservés, le 0 et le 1, ce dernier étant le VLAN par défaut). On peut aussi encapsuler du VLAN dans du VLAN (inception!) via le protocole QinQ, souvent utilisé en Datacenter.
D'autres protocoles tels que VxLAN existent (VxLAN autorisant 2^24 "VLANs" soit 16 millions et des poussières).
Pour résumer, les VLANs nous permettent:
- D'améliorer la gestion du réseau
- D'optimiser la bande passante en séparant les flux (exemple: votre box et son VLAN dédié à la VoIP, un autre VLAN dédié à la TV, etc)
- D'améliorer la sécurité en isolant des sous-réseaux les uns des autres, le seul moyen pour obtenir une communication /inter-vlan/ étant alors un routeur
Routeurs
Un routeur est une machine (serveur, matériel dédié (Cisco, Juniper, etc)) possédant plusieurs interfaces réseaux (physiques ou logiques (VLANs)) connectées à des réseaux différents, dont le but est d'acheminer les paquets IP d'un réseau à l'autre.
Par essence ils fonctionnent sur la couche 3 du modèle OSI. Certains modèles peuvent fonctionner jusqu'à la couche 7 (dans le cas du DPI, /Deep Packet Inspection/) pour offrir des options de Qualité de Service (/QoS/) en fonction des protocoles utilisés par exemple.
Protocoles réseaux
Encapsulation
Il est important de comprendre le concept d'encapsulation. En réseau, on aime bien encapsuler et décapsuler des trucs 
Tous les protocoles dont nous parlons sont encapsulés les uns dans les autres. Dans le modèle TCP/IP, ça nous donne:
- Les données (couche application) qu'on envoie sont encapsulées dans un segment TCP, UDP, ICMP ou IGMP
- Ce segment est lui-même encapsulé dans un paquet IP
- Ce paquet est, au niveau du LAN, encapsulé dans une trame Ethernet
En fait, c'est tellement fort, qu'on peut par exemple dans notre couche de données, insérer un paquet IP contenant un segment UDP ou TCP, contenant lui même des données de la couche application, chiffrer le tout, et l'encapsuler dans un segment TCP ou UDP lui même encapsulé dans un paquet IP encapsulé dans une trame ethernet: c'est le concept du VPN (/Virtual Private Network/). Et je ne ferai pas de pub pour NordVPN© et autre vendeurs de bullshit - attention, les VPNs c'est très pratique et utilisé à tous niveaux hein, c'est juste le bullshit
publicitaire avec lequel je ne suis pas d'accord
Ethernet, ARP, VLANs
Ethernet et ARP
Le protocole Ethernet est un protocole fonctionnant sur la couche Liaison du modèle OSI (couche 2).
Il communique à l'aide de trames dont la longueur varie entre 64 et 1512 octets (9000 octets dans le cadre des jumbo frames).
Il s'agit du standard IEEE 802.3 (et dérivés). Le protocole d'origine, défini dans les années 80, utilisait des câbles coaxiaux, qui ont par la suite été remplacés par nos câbles à paires torsadées et nos fibres optiques habituelles. À l'origine, Ethernet proposait des débits de 10Mbps, puis le standard fût étendu pour accepter des débits de plus en plus importants: 100Mbps, 1Gbps, 10Gbps, 40Gbps, 100Gbps...
Afin d'éliminer ou à minima de minimiser les collisions de paquets, tous les périphériques capables de discuter en Ethernet utilisent le protocole CSMA/CD (Carrier Sense Multiple Access with Collision Detect), qui permet à toute machine de transmettre des données sans se soucier de notions de priorité entre les machines appartenant au réseau.
Chaque interface réseau connectée à notre réseau Ethernet est identifiée par son adresse MAC (Media Access Control), identifiant sensé être unique, codé sur 6 octets (et donc 48bits) et affichés sous forme hexadécimale (pour rester facile à lire par les humains ), par exemple, ici, l'adresse MAC de l'interface trunk0 de mon ordinateur:
lidstah@shaggai: ~ $ ifconfig trunk0
trunk0: flags=808843<UP,BROADCAST,RUNNING,SIMPLEX,MULTICAST,AUTOCONF4> mtu 1500
        lladdr c8:5b:76:92:5c:e6
        index 5 priority 0 llprio 3
        trunk: trunkproto failover
                iwm0 port active
                em0 port master
        groups: trunk egress
        media: Ethernet autoselect
        status: active
        inet 192.168.1.12 netmask 0xffffff00 broadcast 192.168.1.255
En règle générale, une adresse MAC est structurée de la sorte:
| 1 bit | 1 bit | 22 bits | 24 bits |
|---|---|---|---|
| unicast (0), multicast (1) | 0 adresse universelle, 1 adresse locale | constructeur | adresse unique matériel |
Trame Ethernet
Une trame Ethernet est de la forme:
| Préambule | Destination | Source | Longueur | Données | FSC (Frame Sequence Check) |
|---|---|---|---|---|---|
| 8 octets | 6 octets (MAC) | 6 octets (MAC) | 2 octets | 46-1498 octets (sauf jumbo frames) | 4 octets |
Le préambule est toujours constitué de 7 octets de la forme 10101010 suivi d'un octet appelé /Start Frame Delimiter/ dont la valeur est toujours 1010101 1 signifiant que l'on va passer à la destination.
De plus, entre chaque trame Ethernet est inséré un Interframe Gap de 12 octets dont chaque bit est à 0.
ARP: Address Resolution Protocol
Le protocole ARP est "à cheval" entre la couche 2 et la couche 3 du modèle OSI. En effet, il fait la relation entre adresse MAC et adresse IP. Chaque machine connectée au réseau maintient une table ARP de correspondance MAC <-> IP.
Par exemple:
lidstah@shaggai: ~ $ arp -a
Host                                 Ethernet Address    Netif Expire    Flags
192.168.1.12                         c8:5b:76:92:5c:e6  trunk0 permanent l
192.168.1.200                        92:24:cd:0a:a7:64  trunk0 19m16s
192.168.1.226                        4e:40:ca:4e:c5:07  trunk0 8m41s
192.168.1.254                        f4:ca:e5:4e:7a:12  trunk0 19m55s
Mais que se passe-t-il lorsqu'on ne connaît pas l'adresse MAC d'une machine dont on connaît l'IP?
Dans ce cas, notre machine va /broadcaster/ une demande spécifique interrogeant tous les membres du réseau Ethernet afin de savoir à quelle adresse MAC correspond l'adresse IP recherchée. Un message ARP de ce type ressemble à:
- Broadcast:
who is 192.168.30.42 tell 192.168.30.41 - Unicast:
192.168.30.42 is 92:24:cd:00:e1:af
Et la réponse est ajoutée à la table ARP du demandeur.
Cependant, il est relativement facile de modifier l'interface MAC d'une interface réseau - et donc, potentiellement, de se "faire passer" pour un autre (/ARP Poisoning/). Ce n'est donc pas nécessairement un moyen fiable d'identification d'une machine.
Unicast, Broadcast et Multicast
Unicast
Une communication /Unicast/ est une communication entre deux machines identifiées par une adresse réseau unique. On parle de communication point à point. C'est le mode de communication utilisé le plus souvent, par exemple lorsque vous consultez un site Web: vous créez une connexion unicast entre votre machine et votre routeur, qui lui même établira une liaison unicast avec le site Web en question.
Multicast
Le Multicast (très souvent utilisé pour le déploiement et pour le streaming) est une diffusion d'un émetteur unique vers plusieurs récepteurs: l'émetteur n'envoie qu'un seul paquet à tous les récepteurs, et c'est le réseau qui se charge de les dupliquer, là où en unicast il aurait fallu envoyer autant de paquets que de récepteurs.
Broadcast
Le broadcast est la communication d'une machine vers l'ensemble des machines du réseau auquel elle appartient. On l'utilise notamment via ARP, ou DHCP. Dans le cas de machines connectées à un switch, le paquet broadcasté est rediffusé sur tous les ports du switch.
L'adresse IP de broadcast d'un réseau est toujours la dernière adresse de son bloc.
Spanning Tree Protocol et boucles de broadcast
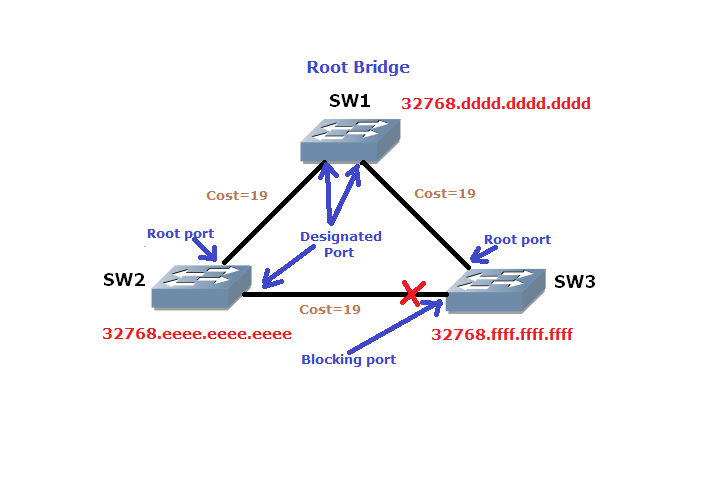
Le protocole STP permet d'éviter, dans le cas de commutateurs connectés "en boucle" pour des raisons de haute disponibilité, le phénomène de boucle de broadcast.
Comme un message broadcast est diffusé sur tous les ports d'un commutateur, dans le cas de notre schéma ci-dessus, il serait donc diffusé aux deux autres switches connectés, qui eux mêmes le rediffuseraient sur tous leurs ports et donc, au premier switch qui rediffuserait le message de broadcast sur tous ses ports et ainsi de suite, tuant proprement et simplement le réseau en l'inondant de trames de broadcast et ce au bout de quelques secondes.
Le protocole STP permet dès lors de "stopper" la transmission d'un broadcast à partir du moment où il a atteint l'ensemble des ports des commutateurs (pour simplifier).
IP
Tableau de conversion binaire
Une adresse IPv4 est un entier non signé de 32 bits. Une adresse IPv6 est un entier non signé de 128bits. Pour la lisibilité par des êtres humains, on divise:
- les adresses IPv4 en 4 octets de 8 bits, affichés en décimal, par exemple
192.168.20.42 - les adresses IPv6 en 8 /quads/ de 16 bits, affichés en hexadécimal, par exemple:
2001:abcd:ef01:2048:ae9e:17ff:fe81:de9b
Ci-dessous un petit tableau pour vous aider à la conversion binaire/décimal:
| Bit | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | Total |
|---|---|---|---|---|---|---|---|---|---|
| Valeur | 2^7 | 2^6 | 2^5 | 2^4 | 2^3 | 2^2 | 2^1 | 2^0 | 255 |
| Décimal | 128 | 64 | 32 | 16 | 8 | 4 | 2 | 1 | 255 |
Note: on peut remarquer qu'un nombre décimal pair converti en binaire se terminera toujours par zéro et qu'un nombre impair se terminera toujours par un
Exercices
- Convertissez l'adresse 10.126.234.12 en binaire
- Convertissez 01111111.00000000.11110001.00000001 en décimal. Le premier
octet de cette adresse IP vous fait penser à quoi? - Convertissez 00001000.00001000.00000100.00000100. Même question que précédemment
- Convertissez l'adresse 212.152.63.97 en binaire
Structure d'un paquet IP
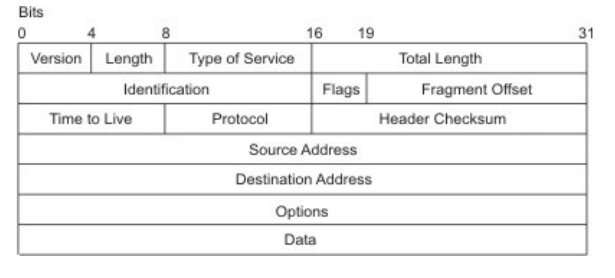
Quelques points intéressants à savoir:
- Source Address: l'adresse source du paquet
- Destination Address: l'adresse de destination du paquet
- Time To Live (TTL): la durée de vie du paquet. Par défaut, le TTL est de 255 /hops/. Chaque passage par un routeur réduit cette valeur, jusqu'à la destination. Si le TTL tombe à zéro avant d'atteindre la destination, il est supprimé et on renvoie une erreur ICMP à l'émetteur (11, /Time Exceeded/). Le but est ici d'éviter que nos paquets restent indéfiniment à "tourner" sur Internet si la destination n'est pas disponible (paquers fantômes).
- Protocol: le protocole qui va être utilisé dans la partie "Data" du paquet: TCP, UDP, ICMP, etc
- Flags et Options: définissent plusieurs paramètres, par exemple le flag Urgent.
Classes de réseaux IPv4
Même si on ne se sert plus vraiment des classes de sous-réseaux IPv4, ils vont nous permettre de manipuler des blocs d'adresses IP en les convertissant en binaire et en effectuant des opérations entre adresse IP et masque de sous réseau (ET logique).
Identifiant réseau et broadcast IPv4
Par convention, la première adresse IP d'un réseau est appelée identifiant réseau. Bien qu'attribuable de nos jours, certains matériels ne la reconnaissent pas et il est donc déconseillé de l'assigner à une machine du réseau. L'identifiant réseau est toujours un chiffre pair, tous les bits /hôte/ étant à zéro. (on va voir ça dans la partie masques de sous-réseau)
De même, la dernière adresse IP d'un sous-réseau (tous les bits hôtes à 1) est l'adresse dite de /broadcast/, et n'est pas assignable à une machine (sauf si vous voulez des soucis :p). Elle est toujours impaire.
Par exemple, le réseau 192.168.10.0/24 aura pour:
- identifiant réseau: 192.168.10.0
- broadcast: 192.168.10.255
Mais par exemple, le réseau 192.168.10.128/25 aura pour:
- identifiant réseau: 192.168.10.128
- broadcast: 192.168.10.255
Et pour finir, le réseau 192.168.10.0/25 aura pour:
- identifiant réseau: 192.168.10.0
- broadcast: 192.168.10.127
Réseaux Privés RFC 1918 (non routables sur Internet)
Pour les classes A,B et C de réseaux il existe trois sous-réseaux non-routables sur Internet, dédiés à l'usage privé/interne:
- Classe A: 10.0.0.0/8 (abrégé 10/8)
- Classe B: 169.254.0.0/16 (AVAHI/APIPA) et 172.16.0.0/12 (172.16/12)
- Classe C: 192.168.0.0/16 (192.168/16)
Classe A
Les réseaux de classe A sont des réseaux dont le premier bit du premier octet de l'adresse est à 0.
Ils s'étendent de 0.0.0.0 à 127.255.255.255, 127.0.0.0 à 127.255.255.255 étant réservé à localhost - loopback, c'est à dire le réseau interne de votre ordinateur. En effet, certains services exécutés par votre système d'exploitation peuvent vouloir communiquer entre eux en réseau, sans être exposés à l'extérieur, ou tout simplement sans avoir de connexion à un réseau externe.
Un réseau de classe A est donc défini par son premier octet, les 3 octets suivants pouvant être assignés aux hôtes de nos réseaux.
Par exemple, le réseau RFC1918 10.0.0.0/8 est un réseau privé (non routable sur Internet) de classe A. L'adresse 10.255.42.24 aura donc pour forme:
| premier octet | second octet | troisième octet | quatrième octet |
|---|---|---|---|
| 00001010 | 11111111 | 00101010 | 00011000 |
| 10 | 255 | 42 | 24 |
Classe B
Similairement, un réseau de classe B est un réseau dont les deux premiers bits du premier octet ont pour valeur 10.
Dès lors, ils s'étendent de 128.0.0.0 à 191.255.255.255.
Par exemple, l'adresse 168.10.42.5 est une adresse de classe B: en effet, ses deux premiers bits sont 1 et 0:
| premier octet | second octet | troisième octet | quatrième octet |
|---|---|---|---|
| 10101000 | 00001010 | 00101010 | 00000101 |
| 168 | 10 | 42 | 5 |
Le réseau privé 172.16.0.0/12 est le réseau RFC 1918 de la classe B.
Exercice
Calculez l'intervalle d'adresses IPs, l'identifiant réseau et le broadcast de ce sous-réseau.
Classe C
Les réseaux de classe C ont toujours les 3 premiers bits du premier octet de l'adresse à 110. Ils s'étendent donc de:
11000000.00000000.00000000.00000000 à 11011111.11111111.11111111.11111111
Soit de 192.0.0.0 à 223.255.255.255.
Le sous réseau bien connu 192.168.0.0/16 est le sous-réseau RFC1918 de la classe C.
Classe D
Il s'agit du sous-réseau réservé au Multicast. Les quatre premiers bits du premier octet de ce réseau sont toujours 1110. Il s'étend donc de 224.0.0.0 à 239.255.255.255.
Ce sous-réseau (cf partie précédente sur le multicast) est principalement utilisé pour le streaming, la TV par internet, et les déploiements.
Classe E
La classe E est le sous-réseau "expérimental" ou "utilisation future".
les 4 premiers bits de son premier octet sont toujours 1111.
Il s'étend donc de 240.0.0.0 à 255.255.255.255 et... personne ne sait à quoi il sert, même si certains ont leur petite idée à ce sujet
Masques de sous-réseaux, notation CIDR
Lorsqu'on configure l'adresse IP d'un ordinateur (ou d'un routeur, ou autre), l'adresse IP seule n'est pas suffisante, il faut aussi renseigner le masque de sous-réseau (subnet mask).
Un masque de sous-réseau indique combien de bits sont réservés pour l'identifiant de notre sous-réseau.
Lorsqu'on essaie de contacter une autre machine disposant d'une autre adresse IP, la pile TCP/IP de l'OS va calculer, à l'aide d'un ET logique (booléen, AND en langue de Shakespeare) si l'IP de l'émetteur et du récepteur appartiennent au même sous-réseau. Dans le cas contraire, le paquet sera envoyé à la passerelle du réseau.
L'opérateur booléen ET (AND):
- 0 AND 0 = 0
- 1 AND 0 = 0
- 1 AND 1 = 1
Imaginons que nous soyons 192.168.10.16, netmask 255.255.255.128, et que nous voulons contacter 192.168.10.64.
On convertit tout ce beau monde en binaire, d'abord notre adresse IP:
| IP dest | 192 | 168 | 10 | 64 |
|---|---|---|---|---|
| binaire | 11000000 | 10100100 | 00001010 | 01000000 |
Et notre masque de sous-réseau:
| Masque | 255 | 255 | 255 | 128 |
|---|---|---|---|---|
| binaire | 11111111 | 11111111 | 11111111 | 10000000 |
Appliquons un ET logique à notre couple IP/masque:
| IP binaire | 11000000 | 10100100 | 00001010 | 01000000 |
|---|---|---|---|---|
| Masque binaire | 11111111 | 11111111 | 11111111 | 10000000 |
| Résultat | 11000000 | 10100100 | 00001010 | 00000000 |
| Décimal | 192 | 168 | 10 | 0 |
Notre adresse IP de destination appartient bien au même sous-réseau.
Le masque de sous-réseau agit donc comme un filtre permettant de déterminer si l'adresse de destination appartient bien au même sous-réseau que la source.
La notation CIDR (/Classless Inter-Domain Routing/) permet d'indiquer plus lisiblement (et facilement) le nombre de bits réservés à notre sous-réseau qu'une notation comme 255.255.192.0 par exemple, qui ici sera résumée par /18 (les 18 premiers bits de l'adresse sont réservés à l'identifiant de notre réseau) et le reste des /bits/ sera attribué à nos hôtes.
Le nombre d'hôtes d'un sous-réseau est toujours égal à 2 puissance le nombre /n/ de bits réservés aux hôtes - 2 (id réseau et broadcast):
hosts=2^n - 2
Par exemple, pour le réseau 192.168.10.16/28, il nous reste:
bits = 32 - 28 = 4
réservés aux hôtes soit:
2^4 - 2 = 14
14 adresses IPs assignables à nos hôtes.
Exercices
- L'adresse 102.124.13.143 appartient-elle au sous-réseau 102.124.0.0/19 ?
- L'adresse 102.124.13.122 appartient-elle au sous-réseau 102.124.0.0/21 ?
- Quel est le plus petit masque de sous-réseau permettant à 194.24.132.10 de communiquer avec 194.24.132.11?
- Combien d'hôtes le sous-réseau 154.145.221.192/26 peut-il accueillir?
- Combien d'hôtes le sous-réseau 154.145.221.192/18 peut-il accueillir? Quel sont son identifiant réseau et son /broadcast/?
subnetting
Le subnetting est l'acte de "découper" un sous-réseau en sous-réseaux plus petits (par exemple pour les assigner à des clients différents, ou pour mieux "coller" à l'architecture physique du réseau (par exemple un MAN), ou pour isoler les messages de broadcast et ainsi réduire le trafic de broadcast, ou tout simplement pour ajouter de la sécurité entre les sous-réseaux ainsi créés (par exemple en les assignant à des VLANs spécifiques).
Par convention, on découpera en règle générale du bloc le plus gros vers le bloc le plus petit. Par exemple, on pourrait découper 192.168.42.0/24 en:
- un bloc /25 de 126 hôtes (et 128 adresses IP)
- un bloc /26 de 62 hôtes (et 64 IPs)
- deux blocs /27 de 30 hôtes (et 32 IPs)
Ce qui nous permet de faire un petit exercice 
Exercice:
Par exemple, on dispose du sous-réseau 89.16.176.0/23. Comment pourrions nous le découper entre un bloc réservé à nos clients (beaucoup d'hôtes), un bloc réservé à notre infrastructure (VMs, etc) et un bloc réservé à notre équipement réseau?
Données:
- Clients: 200 IPs, amené à croître.
- VMs: 57 IPs, ne devrait pas bouger
- Réseau: 29 IPs, idem
UDP, TCP, ICMP, IGMP
TCP
TCP, Transmission Control Protocol, est un protocole de transfert qui permet de s'assurer que chaque segment est bien arrivé à destination.
Il a été mis au point par Vint Cerf et Bob Kahn en 1973/1974 (tout comme IP).
Il utilise un système connu sous le nom d'acquittement positif avec retransmission qui est utilisé pour garantir l'intégrité des données transmises.
Cette technique requiert l'établissement d'une session: le récepteur doit répondre avec des messages d'acquittement (ACK : Acknowledge) au fur et à mesure qu'il reçoit les données.
L'émetteur maintient une table de chaque segment envoyé, et attend le message ACK avant de transmettre le segment suivant. L'émetteur maintient aussi un compteur temporel de l'heure d'envoi du message, et retransmettra le message en cas de timeout.
Pour établir une connexion, l'émetteur et le récepteur vont d'abord engager un dialogue appelé three-way handshake.
Cet échange de "poignées de mains" fonctionne de la sorte:
- La synchronisation entre l'envoi et la réception des segments
- un contrôle de flux, afin d'éviter d'envoyer trop vite les données
- performance: la taille maximum d'un segment (MSS, Maximum Segment Size) doit être assez petite pour limiter les effets de fragmentation au niveau IP
- et enfin on établit la connexion
| Client | Flux de connexion TCP | Serveur |
|---|---|---|
| Port en écoute (ex: port 80, HTTP) | ||
| demande de connexion sur le port 80 | SYN ---> | Accepte |
| <--- SYN/ACK | ||
| ACK ---> | ||
| Envoi de données | ACK,DATA ---> | lecture de données |
| lecture de données | <--- ACK,DATA | Envoi de données |
| Ferme la connexion | FIN/ACK ---> | |
| <--- ACK | Ferme la connexion | |
| <--- FIN/ACK | ||
| ACK ---> | ||
| la connexion est fermée | la connexion est fermée |
Exemple de capture tshark (WireShark):
lidstah@shaggai: ~ $ doas tshark
...
   23   3.268448 192.168.1.12 → 192.168.1.223 TCP 78 29430 → 80 [SYN] Seq=0 Win=16384 Len=0 MSS=1460 SACK_PERM=1 WS=64 TSval=3018863796 TSecr=0
   24   3.269341 192.168.1.223 → 192.168.1.12 TCP 66 80 → 19807 [ACK] Seq=1 Ack=2 Win=236 Len=0 TSval=3786026634 TSecr=1661235936
   25   3.269688 192.168.1.223 → 192.168.1.12 TCP 74 80 → 29430 [SYN, ACK] Seq=0 Ack=1 Win=27960 Len=0 MSS=1410 SACK_PERM=1 TSval=3786026634 TSecr=3018863796 WS=128
   26   3.269689 192.168.1.223 → 192.168.1.12 TCP 66 80 → 21996 [ACK] Seq=1 Ack=2 Win=236 Len=0 TSval=1368919182 TSecr=2802092754
   27   3.269718 192.168.1.12 → 192.168.1.223 TCP 66 29430 → 80 [ACK] Seq=1 Ack=1 Win=16384 Len=0 TSval=3018863797 TSecr=3786026634
   28   3.270018 192.168.1.12 → 192.168.1.223 HTTP 587 GET / HTTP/1.1
   29   3.271624 192.168.1.223 → 192.168.1.12 TCP 66 80 → 29430 [ACK] Seq=1 Ack=522 Win=29056 Len=0 TSval=3786026636 TSecr=3018863797
   30   3.285010 192.168.1.223 → 192.168.1.12 TCP 1464 HTTP/1.1 200 OK  [TCP segment of a reassembled PDU]
   31   3.285115 192.168.1.223 → 192.168.1.12 HTTP 711 HTTP/1.1 200 OK  (text/html)
...
UDP
UDP, User Datagram Protocol, est un modèle de transmission simple. À la différence de TCP, il n'utilise pas de mécanisme d'acquittement et de mise en ordre des paquets envoyés (il fonctionne en mode fire and forget). Dès lors, les segments UDP transmis peuvent arriver dans le désordre, voire pas du tout. Cependant, vu qu'il ne nécessite pas d'acquittement, il est nettement plus rapide que TCP (latence plus faible) et est donc utilisé par un certain nombre de protocoles, parmi lesquels:
- DNS (Domain Name System)
- VoIP et TV par IP
- TFTP (Trivial File Transfer Protocol)
- SNMP (Simple Network Management Protocol)
Peut-être plus proche de vous, c'est aussi le protocole utilisé majoritairement par les jeux en ligne et particulièrement les FPS. Maintenant vous savez pourquoi Igor semble se téléporter lorsque vous jouez à un FPS - certains joueurs mal-intentionnés induisent des erreurs de transmission afin d'obtenir un avantage (relatif).
ICMP
ICMP signifie Internet Control Message Protocol. C'est un protocole de diagnostic et de rapport d'erreurs. Il est encapsulé, comme UDP, dans un seul datagramme IP et n'est donc pas "fiable" au sens transmission de données.
Ce protocole est notamment utilisé par les commandes ping, traceroute/tracepath (tracert sous Windows©).
Exemples:
lidstah@shaggai: ~ $ ping -c 4 google.fr
PING google.fr (216.58.204.131): 56 data bytes
64 bytes from 216.58.204.131: icmp_seq=0 ttl=54 time=40.992 ms
64 bytes from 216.58.204.131: icmp_seq=1 ttl=54 time=21.711 ms
64 bytes from 216.58.204.131: icmp_seq=2 ttl=54 time=38.487 ms
64 bytes from 216.58.204.131: icmp_seq=3 ttl=54 time=14.079 ms

--- google.fr ping statistics ---
4 packets transmitted, 4 packets received, 0.0% packet loss
round-trip min/avg/max/std-dev = 14.079/28.817/40.992/11.285 ms

lidstah@shaggai: ~ $ traceroute lidstah.info
traceroute to lidstah.info (89.234.176.135), 64 hops max, 40 byte packets
 1  192.168.1.254 (192.168.1.254)  1.408 ms  0.998 ms  1.055 ms
 2  val44-1-78-228-105-254.fbx.proxad.net (78.228.105.254)  6.812 ms  6.943 ms  6.841 ms
 3  213.228.11.254 (213.228.11.254)  20.374 ms  7.924 ms  7.548 ms
 4  nantes-crs8-2-be1003.intf.routers.proxad.net (194.149.161.177)  9.229 ms  10.181 ms  9.742 ms
 5  p11-crs16-1-be1110.intf.routers.proxad.net (194.149.162.109)  14.552 ms  16.644 ms  14.394 ms
 6  194.149.166.38 (194.149.166.38)  14.614 ms  16.787 ms  14.145 ms
 7  be4204.ccr32.par04.atlas.cogentco.com (149.11.115.13)  14.246 ms  14.093 ms  14.66 ms
 8  be2102.ccr41.par01.atlas.cogentco.com (154.54.61.17)  15.598 ms be2103.ccr42.par01.atlas.cogentco.com (154.54.61.21)  15.092 ms  14.896 ms
 9  be3518.agr21.par01.atlas.cogentco.com (130.117.50.42)  15.23 ms  14.619 ms be2097.agr22.par01.atlas.cogentco.com (130.117.49.77)  15.242 ms
10  te0-0-2-2.rcr11.nte01.atlas.cogentco.com (154.25.12.9)  23.419 ms te0-0-2-0.rcr11.nte01.atlas.cogentco.com (154.25.12.13)  23.793 ms te0-0-2-2.rcr11.nte01.atlas.cogentco.com (154.25.12.9)  23.644 ms
11  te0-0-2-0.nr11.b015567-0.nte01.atlas.cogentco.com (154.25.10.238)  33.575 ms te0-0-2-2.nr11.b015567-0.nte01.atlas.cogentco.com (154.25.10.242)  23.061 ms te0-0-2-0.nr11.b015567-0.nte01.atlas.cogentco.com (154.25.10.238)  23.157 ms
12  149.11.52.83 (149.11.52.83)  22.235 ms  22.599 ms  22.969 ms
13  dramm-hud.faimaison.net (89.234.176.3)  28.542 ms  22.527 ms  22.706 ms
IGMP
IGMP signifie Internet Group Management Protocol. Ce protocole va gérer les membres d'une liste Multicast. Multicast n'est pas orienté connexion, ses paquets utilisent UDP comme protocole de transport. Les routeurs sur le chemin d'un message Multicast doivent être configurés pour supporter ce protocole.
Multicast est aussi utilisé par le protocole OSPF pour la communication entre routeurs utilisant ce protocole de routage dynamique.
Routage
Table de routage
Toute machine connectée à un réseau maintient une table de routage, lui indiquant comment joindre (par quelle passerelle, c'est à dire par quel routeur) tel réseau.
- Sous GNU/Linux, on utilisera les commandes
routeouip route showpour l'afficher. - Sous BSD, on utilisera la commande
route. - Sous Windows, on utilisera la commande
route print.
Par exemple, sur une de mes VMs:
lidstah@deb-interco:~$ ip route show
default via 192.168.1.254 dev br0 onlink
10.253.105.0/24 via 10.253.105.2 dev tun0
10.253.105.2 dev tun0 proto kernel scope link src 10.253.105.1
10.253.106.0/24 via 10.253.106.2 dev tun1
10.253.106.2 dev tun1 proto kernel scope link src 10.253.106.1
172.24.0.0/24 dev wg0 proto kernel scope link src 172.24.0.2
172.24.1.1 dev wg1 scope link
172.24.2.0/24 dev wg2 proto kernel scope link src 172.24.2.2
192.168.1.0/24 dev br0 proto kernel scope link src 192.168.1.187
192.168.42.0/24 dev ens19 proto kernel scope link src 192.168.42.253
On remarquera la route par défaut, qui passe par la passerelle de mon
réseau local (freeboite): si je veux joindre un réseau qui n'est pas
renseigné dans ma table de routage, j'essaierai de le joindre via
cette passerelle.
NAT (Network Address Translation)
Si nous prenons l'exemple d'un LAN domestique, les adresses IPs à l'intérieur de ce LAN sont des adresses RFC 1918 non routables sur Internet.
Par contre votre "box", c'est à dire votre routeur, dispose de deux (ou plus) interfaces réseau:
- Une de ces interfaces est sur votre LAN (c'est elle qui a l'IP de la /gateway/ de votre LAN)
- La seconde dispose d'une adresse IP publique sur le réseau de votre opérateur
La solution ici est de remplacer l'IP locale de votre machine dans le champ source du paquet IP par l'IP publique de votre "box": c'est le NAT. le routeur conserve ensuite une table IP locale/port pour le retour du paquet.
Statique
Une table de routage statique est une table de routage où les entrées ont été ajoutées manuellement. Si cette méthode est suffisante pour des réseaux de petite taille, ce n'est pas une solution adaptée à des réseaux de grande tailles et évoluant rapidement pour lesquels on préfèrera utiliser des protocoles de routage dynamiques.
Dynamique
Note: on sort du cadre de ce cours, mais il est important, à minima, de connaître l'existence de ces protocoles
Type de protocoles de routage
Protocoles de routage internes
Dans ces protocoles de routage internes, on distingue généralement trois types de protocoles:
-
Les protocoles dits à état de lien: ils transmettent la totalité des informations de routage à tous les routeurs participants, et établissent des tables de voisins directement connectés. C'est le cas d'OSPF. Chaque nœud du réseau envoie les données correspondant aux nœuds auxquels il peut se connecter. Ces données sont ensuite assemblées dans une carte du réseau par chaque routeur, qui va ensuite déterminer, en utilisant un algorithme de chemin le plus court (par exemple, dans le cas d'OSPF, l'algorithme de Dijkstra) afin de construire un arbre dont le nœud est la racine et où le chemin entre la racine vers tout autre nœud du réseau est le chemin le moins coûteux (en termes de /hops/). Cet arbre est ensuite utilisé pour construire la table de routage du nœud. Cependant, c'est un processus coûteux en terme de puissance de calcul au moins au début, lorsque les routeurs vont échanger leurs informations, construire leur arbre du réseau et enfin dériver leur table de routage de cet arbre.
-
Les protocoles à vecteur de distance: Ils ne transmettent que les informations concernant les meilleures routes. C'est le cas de RIP ou d'IGRP - anciens protocoles donc. Le concept est assez simple (ils utilisent l'algorithme Bellman-Ford): on assigne un coût (ou un poids) à chaque lien entre chaque nœud du réseau. Chaque nœud du réseau relaie ensuite les paquets du point A au point B en utilisant le chemin de moindre coût. Cependant, si on dépasse quelques hops de distance, ces protocoles peuvent devenir instables, c'est à dire ne pas choisir la meilleure route du point A au point B.
-
Et enfin les hybrides entre les deux types définis ci-dessus, comme par exemple EIGRP.
Protocole de routage externe
Comme on vient de le voir, ces protocoles de routage dits internes sont utilisés à l'intérieur d'un AS. Leurs défauts ne permettent pas de les utiliser entre Systèmes Autonomes: soit les informations transmises ne seront pas fiables dans le cas des protocoles à vecteur de distance, soit la quantité d'information transmise et la puissance de calcul nécessaire ne sont pas viables dans le cas des protocoles à état de lien.
Dès lors, on utilise des protocoles de routage externes dits à vecteur de chemin, Path Vector Protocols, comme BGP. Dans le cas de BGP, les routeurs de frontière d'un AS (qu'on va appeler les speakers) envoient ces informations aux routeurs d'autres AS auxquels ils sont appairés (peer, peering) afin d'annoncer leurs routes (en général, ils vont "dire" aux routeurs avec lesquels ils sont appairés le ou les sous-réseaux - le surnetting s'applique ici - qu'ils sont en mesure de router). On peut aussi utiliser BGP en interne d'un Système Autonome. On parle alors d'iBGP.
RIP
RIP est un des premiers protocoles de routage dynamique. Il n'est quasiment plus utilisé de nos jours. Je ne vais pas m'étendre dessus. C'est un protocole à vecteur de distance.
OSPF
Tout d'abord, OSPF est un IGP dit à état de lien, ce qui signifie que tous les routeurs du réseau connaissent la topologie complète du réseau en question. À partir de cette topologie et des caractéristiques des liens établis à l'intérieur du réseau (liaison série, liaison FastEthernet, GigabitEthernet, Fibre optique, etc), nos routeurs peuvent choisir le meilleur chemin pour chaque destination du réseau interne. Nos routeurs déterminent donc la meilleure route en fonction de ces deux paramètres:
- Topologie du réseau
- Vitesse des liens
En utilisant l'algorithme de Dijkstra (s'il y a des matheux ou matheuses ici... faites vous plaisir avec l'article Wikipedia qui décrit cet algorithme ), nos routeurs vont attribuer un /coût/ à chaque lien, et déterminer le plus court chemin en fonction de ces coûts. Ces coûts constituent la métrique utilisée par OSPF.
De même, OSPF introduit la notion de zones (areas, aussi appelées aires), dans le but d'alléger le processus (coûteux en terme de temps CPU) des routeurs de notre réseau interne. Au sein d'une même aire, tous les routeurs se connaissent, c'est à dire qu'ils se partagent les informations sur leurs états de liens. Entre aires, les routeurs n'ont connaissance que des routes disponibles. Par exemple, un routeur de l'area 0 (dite backbone) connaîtra l'état des autres routeurs de la zone 0, mais ne connaîtra que les routes et réseaux disponibles dans l'area 1: il ne connaîtra pas l'état des liens dans la zone 1.
On distingue plusieurs types de routeurs OSPF:
- Les routeurs internes: ce sont des routeurs dont toutes les interfaces sont dans la même aire OSPF
- Les Area Border Router, ABR, qui disposent d'interfaces dans des aires différentes. Un routeur ayant une "patte" dans l'aire 0 et une autre dans l'aire 1 est un ABR. C'est aussi un routeur backbone, cf plus bas.
- Les Autonomous System Boundary Router, ASBR, sont des routeurs qui injectent dans OSPF des routes provenant d'autres protocoles de routage (au hasard, BGP), ou des routes statiques.
- Les Routeurs backbone sont des routeurs dont au moins une interface appartient à la zone 0. Typiquement, tous les ABR sont des routeurs backbone.
EIGRP
Enhanced Interior Gateway Routing Protocol était un protocole propriétaire Cisco, il a été libéré en 2013. C'est un IGP, tout comme OSPF. EIGRP utilise son propre protocole de session, sur la même couche OSI que TCP (i.e. la couche 4): Reliable Transport Protocol, RTP, à ne pas confondre avec le protocole RTP utilisé en VoIP . EIGRP est un protocole à à vecteur de distance hybride, mais qui, par le fonctionnement de ses mises à jour de routage, profite aussi de certains avantages des protocoles à état de lien comme OSPF.
EIGRP prend en charge le VLSM, tout comme OSPF, et, tout comme OSPF, utilise multicast pour communiquer entre voisins, sur l'adresse 224.0.0.10. Un des avantages d'EIGRP est sa faculté à effectuer du Load-Balancing (jusqu'à 6 liens) - il est aussi capable de répartir la charge sur des liens dont le coût (la métrique) est différent. Il est aussi capable de calculer une route de secours en cas de problème, c'est à dire qu'il conserve en mémoire deux routes pour une destination donnée: la route principale (celle qui dispose de la meilleure métrique), et une route secondaire.
BGP
Border Gateway Protocol est un EGP et IGP utilisé... à peu près partout. Vous en aurez besoin notamment si vous:
- Travaillez chez un opérateur
- Travaillez dans une TGE (très grande entreprise) et notamment dans son cœur de réseau
- Gérez un point d'échange (IXP :p) entre opérateurs
BGP est un protocole utilisant TCP, sur le port 179. Pour établir une relation de voisinage entre deux routeurs, il est nécessaire de la configurer manuellement sur chaque routeur: BGP n'apprend pas "tout seul" avec quels "voisins" discuter, notamment parce qu'en général, ces "voisins" appartiennent à d'autres entreprises .
surnetting
Imaginons que vous disposiez d'un routeur annonçant les réseaux suivants:
- 192.168.10.0/26
- 192.168.10.64/26
- 192.168.10.128/26
- 192.168.10.192/26
Plutôt que d'annoncer ces quatres routes aux autres routeurs, on va seulement leur annoncer 192.168.10.0/24, afin d'éviter de remplir inutilement leur table de routage. C'est ce qu'on appelle le surnettin. On appelle aussi cette opération résumer des routes.