Historique
Au fur et à mesure qu'ARPANET puis Internet se complexifiait, passant de
quelques dizaines de machines dans les années 70 à plusieurs milliers de
machines réparties sur toute la planète dans les années 80, pour en
arriver aux milliards de machines actuellement connectées, du smartphone
au cluster de calcul, les protocoles permettant l'acheminement des
données (le routage) ont dû, nécessairement, évoluer pour parer à cette
complexité accrue.
Dans le courant des années 80, il est devenu évident qu'il était
nécessaire d'avoir des protocoles de routage qui soient:
- Capables :: de s'adapter aux modifications du réseau interne, si possible
sans intervention humaine: on peut citer par exemple RIPv1 (1988),v2 et
RIPng, remplacés par OSPF, IGRP et EIGRP (et aussi IS-IS par exemple),
afin de rendre résilients aux pannes ces réseaux internes. - Capables :: de fonctionner sur des réseaux pouvant comprendre des
centaines, voire des milliers de nœuds (OSPF, IS-IS) - Capables :: de communiquer entre réseaux gérés par des entités différentes
(Systèmes Autonomes, on y revient), c'est à dire capables de communiquer
"à l'extérieur" les modifications et routes accessibles, notamment via
la normalisation en 1992 du VLSM (/Variable Length Subnet Mask/), et
l'apparition en 1982 d'EGP (Exterior Gateway Protocol), remplacé par la
suite par BGP (Border Gateway Protocol)
C'est à la même époque (années 80), que le protocole DNS fût créé pour
remplacer les anciens fichiers HOSTS.TXT.
De même, de part l'évolution matérielle constante, les anciens
/Interface Message Processors/, IMP (on retrouve de temps en temps cette
dénomination) furent progressivement remplacés par les routeurs tels
qu'on les connaît aujourd'hui. Développés à la fin des années 60 et
pendant les années 70, ils restèrent le cœur d'ARPANET jusqu'en 1989.
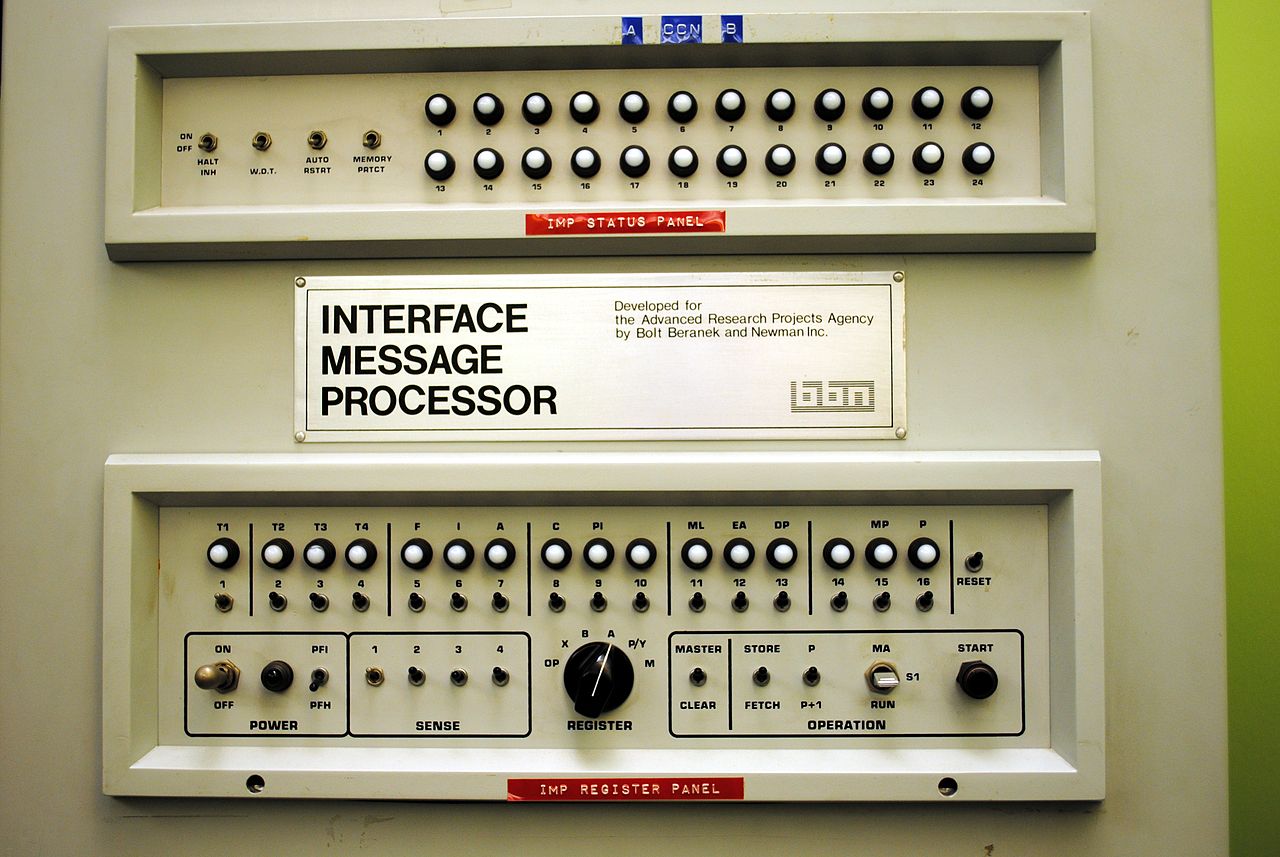
Un des premiers IMP, en 1969, assez... "rustique" (source: Wikipédia
en), avec une bande passante phénoménale (pour l'époque) de 50 kilobits
par seconde. Pour l'anecdote, le logiciel et le protocole de
communication de ces machines sont décrits dans la RFC 1.
En 1980, Bill "Router Man" Yeager développe le premier routeur
multi-protocoles à l'Université de Stanford. Il est à l'époque aidé de
Len Bosack et Sandy Lerner, qui créeront d'ailleurs une petite PME du
nom de Cisco.
Le tout premier routeur Cisco sorti en 1986. Nommé AGS pour /Advanced
Gateway Server/, il supportait TCP/IP, PUP, entre autres protocoles. Il
disposait déjà, à l'époque, d'une interface (FDDI) capable de supporter
100Mbps. Suivit l'AGS+, remplaçant le CPU Motorola 68020 de l'AGS par un
68040 nettement plus "costaud":
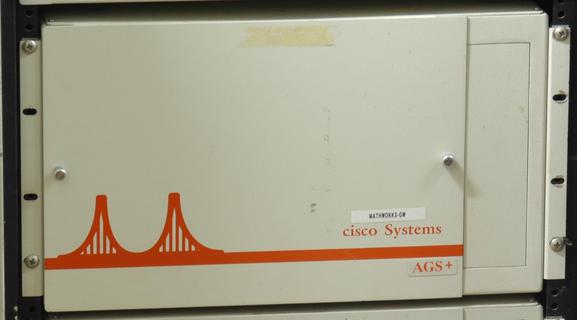
(source: rcsri.org (Retro-Computing Society of Rhode Island, Inc.))
Dans le même temps, apparaissaient les premiers commutateurs Ethernet
100Mbps (Grand Junction, 1993):
(source: rcsri.org (Retro-Computing Society of Rhode Island, Inc.))
Au fur et à mesure de l'évolution du réseau, sont apparus des modèles de
routeurs de plus en plus compacts et de plus en plus puissants, avec des
interfaces à 1Gbps, puis 10Gbps, etc. Les CPUs "classiques" utilisés
dans les premiers routeurs sont maintenant aidés de circuits ASICs
spécialisés (tout comme pour le minage de bitcoins :p). On peut citer
les routeurs Cisco de la série ASR:
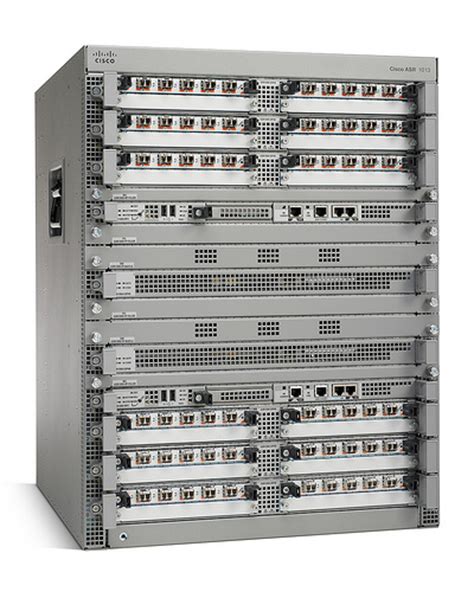
(source: Cisco)
De même, de nombreux concurrents sont apparus au fil du temps: Juniper,
Mikrotik, Brocade, Allied Telesis, DLink (oui oui), etc, visant à la
fois le marché d'entreprise et le marché PME/PMI voire particuliers
(passionnés).
De même, dans des environnements ne nécessitant pas des performances
"ultimes" (et même là...), il est tout à fait possible d'utiliser des
APUs ou des serveurs sous GNU/Linux ou *BSD (FreeBSD pour les perfs,
OpenBSD pour les parano... euh, la sécurité), et bénéficier de la
syntaxe "Cisco" IOS via le logiciel /Quagga/, qui est une surcouche aux
différents /daemons/ réseau disponibles (par exemple bgpd, ospfd,
routed, etc) offrant une syntaxe et une CLI quasiment identiques à celle
d'un routeur Cisco.
Définitions et Rappels
Système Autonome (AS)
Définition
Un /Système Autonome/, ou en anglais /Autonomous System/, abrégé /AS/,
c'est un ensemble de réseaux IP publics (i.e., utilisant des adresses IP
(v4 ou v6) routables sur Internet, ce qui exclut bien évidemment les IPs
RFC1918 et similaires (multicast, expérimental, etc)) généralement sous
le contrôle d'une organisation unique (administration, université,
entreprise, association, rarement un particulier (chanceux...)).
Au sein d'un AS, on utilisera des protocoles de routage /internes/,
comme par exemple OSPF ou EIGRP.
Entre deux AS, le routage est qualifié d'externe, et on utilisera par
exemple BGP pour annoncer les routes de chaque AS entre les deux AS.
Jusqu'en 2007, les AS étaient identifiés par un numéro codé sur 16 bits.
Ce numéro est appelé ASN (Autonomous System Number). Comme il y a plus
de 200000 Numéros de Systèmes Autonomes actuellement alloués (mais pas
forcément utilisés!), cette valeur est désormais codée sur 32 bits (RFC
4893). Par exemple, l'association FAImaison sur Nantes dispose de l'AS
numéro 203432.
On peut obtenir les informations sur un AS via la base /whois/, par
exemple:
$ whois AS174
# snip comments
ASNumber:       174
ASName:         COGENT-174
ASHandle:       AS174
RegDate:        1996-05-15
Updated:        2012-03-02
Ref:            https://whois.arin.net/rest/asn/AS174


OrgName:        Cogent Communications
OrgId:          COGC
Address:        2450 N Street NW
City:           Washington
StateProv:      DC
PostalCode:     20037
Country:        US
RegDate:        2000-05-29
Updated:        2017-08-17
Ref:            https://whois.arin.net/rest/org/COGC
# etc etc
Où on voit que l'AS 174 appartient à la société américaine Cogent, un
des (sinon le) plus gros transitaires.
Numéros de Systèmes Autonomes réservés
Plusieurs numéros d'AS sont réservés. On peut distinguer:
Les numéros d'AS réservés à un usage personnel. Ces numéros ne doivent
jamais être utilisés sur un réseau relié à Internet (tout comme les
adresses IP RFC 1918 qui ne sont pas routables, ou les adresses IP CGN
(Carrier-Grade NAT, utilisées /à l'intérieur/ des réseaux de
fournisseurs d'accès))
Les numéros d'AS réservés pour la documentation, les codes d'exemples,
etc (RFC 5398)
Le numéro d'AS 23456 (pratique), qui est réservé à la communication
entre les routeurs de bordures ne supportant pas les ASN 32 bits et ceux
les supportant.
Et les numéros d'AS qui sont réservés, point  .
Ci-dessous un petit tableau récapitulatif:
| Numéro | Description | RFC |
|---|---|---|
| 0 | Réservé | AS 0 Processing |
| 23456 | AS TRANS | RFC 6793 |
| 64496-64511 | Documentation | RFC 5398 |
| 64512-65534 | Usage Personnel | RFC 6996 |
| 65535 | Réservé | no info |
| 65536-65551 | Documentation | RFC 5398 |
| 65552-131071 | Réservé | no info |
| 4200000000-4294967295 | Usage Personnel | RFC 6996 |
| 4294967295 | Réservé | no info |
Registres Internet Régionaux (RIR), Registres Internet Locaux (LIR), obtenir un ASN, un bloc d'IPs (v4, v6)
Il faut savoir que jusqu'en 1990, seule l'IANA (Internet Assigned
Numbers Authority) était en mesure d'attribuer des blocs d'IP à des AS.
La RFC 1174 a permis la création des Registres Internet Régionaux (RIR).
Le premier est le RIPE NCC (RIPE: Réseaux IP Européens (oui, en
français, et donc RIPE se prononce RIPE et pas RAYPE :p), NCC: Network
Coordination Centre) qui est en charge de l'attribution des ASN et blocs
d'IP (v4 ou v6) qui gère la zone Europe/Russie/Moyen-Orient.
Viennent ensuite:
- AfriNIC qui est le RIR Africain
- APNIC qui est le RIR de la zone Asie-Pacifique
- ARIN qui est le RIR de la zone Amérique du Nord (Canada et USA)
- LACNIC qui est le RIR de la zone Amérique Centrale/Amérique du Sud
Les Registres Internet Locaux (/LIR/) sont eux membres du RIR
correspondant à leur zone géographique et distribuent les blocs d'IP qui
leurs sont alloués à l'échelle locale (pays, région, etc). Par exemple,
en France, la coopérative OpDop est un LIR, mais ce n'est pas le seul
LIR Français (il y en a plus de 2000, pas tous basés en France
cependant).
Il faut noter que pour obtenir un bloc d'adresses IPv4, qui devient une
ressource rare, il est nécessaire de "montrer patte blanche" au LIR et
au RIPE-NCC afin de justifier le besoin de la ressource. Par exemple, il
est inutile d'espérer obtenir un /16 si un /24 est suffisant pour les
besoins de notre AS.
Concernant les blocs d'adresses IPv6, un LIR vous fournira en général un
/40 (que vous pourrez par exemple découper en /44 suivant vos besoins,
et servir des /56 ou /64 à vos utilisateurs finaux).
Transit IP et Peering
Transit IP
"La fibre, c'est très important pour le transit" - /un rigolo sur frnog/
Le transit IP, c'est la bande passante vendue par le transitaire à un
autre AS. Les /datacaps/ n'existent pas, la seule valeur marchande sur
Internet, c'est la bande passante. (de là à en conclure que nos FAIs se
remplissent les poches sur le dos des consommateurs avec leurs forfaits
smartphones /datacappés/... Il n'y a qu'un pas que je vous laisse
franchir )
La bande passante utilisée l'est généralement au 95ème percentile
mensuel. C'est à dire que si vous avez un accord de transit avec un
transitaire vous fournissant 100Mbps au 95è percentile, vous pouvez
occasionnellement dépasser cette limite (par exemple un /burst/ à
300Mbps pendant une heure) sans impacter la facture. En cas de
dépassement, le dépassement est en général facturé au Mbps
supplémentaire (et ça peut très vite piquer!).
Il y a trois niveaux (/Tier/) d'opérateurs de transit:
- Les opérateurs Tier 1: ils n'achètent pas de transit, ils le
fournissent. Ils ne fonctionnent que par accords de /peering/ entre eux
et d'autres opérateurs (principalement d'autres Tier 1) - Les opérateurs Tier 2: ils sont mixtes entre Tier 1 et Tier 3, c'est à
dire qu'ils dépendent d'une ou plusieurs offres de transit, et proposent
eux-mêmes des offres de transit. - Les opérateurs Tier 3: Ils ne proposent pas d'offre de transit. Dès
lors, ils payent toutes leurs connexions.
En France, on peut par exemple citer Open Transit (Orange... "open",
hum), Liazo, Nerim...
Dans le monde, on peut citer Cogent, Level 3, Hurricane Electric...
Peering
L'appairage ou /peering/ en anglais consiste à échanger du trafic
Internet entre pairs (i.e. AS). Le peering est régulé en France depuis
le différend entre Orange (Open Transit) et Cogent.
Le peering peut être gratuit lorsque les échanges de bande passante sont
équilibrés (je te donne 50Mbps, tu me donnes 50Mbps), ou payants lorsque
les échanges sont déséquilibrés (en général, on considère qu'au delà
d'un ratio de 2.5, le peering devient payant).
Pour mettre en place un peering entre deux AS, il faut:
- Un accord commercial et/ou contractuel de peering entre les deux
parties. - Une possibilité d'interconnexion physique entre les réseaux des deux
parties: par exemple, dans le même Datacenter (Cogent, Oceanet à
Nantes)/Colocation (TH2 à Paris par exemple) où les deux AS ont un PoP
(/Point of Presence/) - Et enfin une liaison logique entre les réseaux des deux AS afin de
permettre l'échange de routes via un protocole de routage externe (BGP
par exemple)
Les gros centres de peering sont appelés /Internet Exchange Point/, IXP.
Ce sont en général (mais il en existe des petits) des centres où
uniquement les gros opérateurs Tier 1 et Tier 2 disposent d'un PoP et
peuvent mettre en place du peering entre eux. On peut citer:
- En France: SFINX (Renater, universités), France-IX, Equinix IX Paris,
PARIX (Orange), FR-IX (Opdop) pour les Parisiens, ou Ouest-IX,
Breizh-IX, FR-IX (Opdop, en cours de développement sur Rennes, Le Mans
et Marseille), AuvernIX, LyonIX, GrenoblIX, NormandIX en province (il
nous manque juste AsterIX et Obel-IX... hum, désolé) - Monde: AMS-IX, l'exchange point d'Amsterdam (près de 5Tbps de trafic en
pointe), TORIX, LINX, NYIIX, etc, etc, etc...
Peering et BGP
On y reviendra dans le chapitre sur BGP, mais il est important de savoir
qu'il est possible de différencier le traitement du trafic entre /peers/
suivant plusieurs facteurs:
- Préférence locale: on préfèrera utiliser des liens de peering
(non-payants) ou son réseau interne pour acheminer le trafic afin de
minimiser les coûts en bande passante. - /Multi Exit Discriminators/: On prend en compte le coût du routage
interne à l'AS, ce qui peut résulter en des paquets destinés à l'AS peer
transitant par tout le réseau de l'AS avant d'arriver à l'AS peer et
enfin être distribué aux clients de l'AS peer. C'est ce qu'on appelle le
routage en patate froide (/cold potato/), auquel en préfèrera en général
le routage dit /hot potato/, ou sortie la plus proche (ie, le point le
plus proche d'interconnexion entre l'AS "cible" et l'AS "transitaire"),
afin de ne pas surcharger le réseau interne de l'AS "transitaire". - /AS Path/: Le "chemin" entre Systèmes Autonomes suivi par le paquet. On
préfèrera le chemin le plus court là aussi. Par exemple si je peux
atteindre AS24 via deux chemins différents, le premier passant par AS30
puis AS40 puis AS50 avant d'atteindre AS24, et le second passant par
AS174 uniquement avant d'atteindre AS24, je "choisirai" de router ce
paquet directement vers AS174. Cependant, si le réseau interne d'AS174
est peu performant (voire "moisi"), il peut être plus avantageux de
router par le chemin d'AS le plus long.
Types de routes
En général, on définit trois types de routes:
- Les routes directement connectées: c'est le cas d'un routeur directement
connecté à plusieurs sous-réseaux (et donc à plusieurs commutateurs ou à
plusieurs VLANs), qui peut alors directement transmettre les paquets
d'un sous-réseau à l'autre /via/ le protocole de couche de liaison
(généralement Ethernet) - et un peu aussi à l'aide d'ARP - Les routes /statiques/, par exemple:
$ sudo ip route add 192.168.42.0/24 via 192.168.10.1 dev eth0
Qui sont donc configurées /en dur/ dans la table de routage. Pratique
quand on n'a que 2/3 réseaux, ça peut devenir très fastidieux à
maintenir lorsqu'on travaille sur des dizaines ou plus de sous-réseaux,
et de plus, ce n'est pas terrible niveau tolérance de panne: il faut
modifier la route /en dur/ dans la configuration si la route vient à
changer (routeur en panne, changement de la topologie du réseau, etc)
- Les routes /dynamiques/, qui sont /apprises/ via un protocole de routage
dynamique. Le rôle de ce protocole est de communiquer des informations
concernant les réseaux disponibles entre les routeurs /parlant/ ce
protocole et répondants aux critères définis (par exemple la
/communauté/ à laquelle (ou auxquelles) le routeur appartient dans le
cas d'OSPF)
On distinguera les protocoles de routage externes, comme /Border
Gateway Protocol/, BGP, qui échangent les informations de routage entre
/Systèmes Autonomes, Autonomous Systems/ (AS), c'est à dire entre
entités (entreprises, associations, particuliers particulièrement
chanceux, etc) ayant chacune la main sur leur réseau, et les protocoles
de routage internes (IGP), qui transmettent les informations de
routage à l'intérieur d'un Système Autonome, comme par exemple OSPF, RIP
(vieux, vieux, vieux) ou EIGRP.
Protocoles de routage interne
Dans ces protocoles de routage internes, on distingue généralement
trois types de protocoles:
-
Les protocoles dits à /état de lien/: ils transmettent la totalité des
informations de routage à tous les routeurs participants, et établissent
des tables de voisins directement connectés. C'est le cas d'OSPF. Chaque
nœud du réseau envoie les données correspondant aux nœuds auxquels il
peut se connecter. Ces données sont ensuite assemblées dans une carte du
réseau par chaque routeur, qui va ensuite déterminer, en utilisant un
algorithme de chemin le plus court (par exemple, dans le cas d'OSPF,
l'algorithme de Dijkstra) afin de construire un arbre dont le nœud est
la racine et où le chemin entre la racine vers tout autre nœud du réseau
est le chemin le moins coûteux (en termes de /hops/). Cet arbre est
ensuite utilisé pour construire la table de routage du nœud. Cependant,
c'est un processus coûteux en terme de puissance de calcul au moins au
début, lorsque les routeurs vont échanger leurs informations, construire
leur arbre du réseau et enfin dériver leur table de routage de cet
arbre. -
Les protocoles à /vecteur de distance/: Ils ne transmettent que les
informations concernant les meilleures routes. C'est le cas de RIP ou
d'IGRP - anciens protocoles donc. Le concept est assez simple (ils
utilisent l'algorithme Bellman-Ford): on assigne un coût (ou un poids) à
chaque lien entre chaque nœud du réseau. Chaque nœud du réseau relaie
ensuite les paquets du point A au point B en utilisant le chemin de
moindre coût. Cependant, si on dépasse quelques /hops/ de distance, ces
protocoles peuvent devenir instables, c'est à dire ne pas choisir la
meilleure route du point A au point B. -
Et enfin les hybrides entre les deux types définis ci-dessus, comme par
exemple EIGRP.
Protocoles de routage externe
Comme on vient de le voir, ces protocoles de routage dits /internes/
sont utilisés /à l'intérieur/ d'un AS. Leurs défauts ne permettent pas
de les utiliser entre Systèmes Autonomes: soit les informations
transmises ne seront pas fiables dans le cas des protocoles à vecteur de
distance, soit la quantité d'information transmise et la puissance de
calcul nécessaire ne sont pas viables dans le cas des protocoles à état
de lien.
Dès lors, on utilise des protocoles de routage externes dits à
/vecteur de chemin/, /Path Vector Protocols/, comme BGP. Dans le cas de
BGP, les routeurs de frontière d'un AS (qu'on va appeler les /speakers/)
envoient ces informations aux routeurs d'autres AS auxquels ils sont
appairés (/peer, peering/) afin d'annoncer leurs routes (en général, ils
vont "dire" aux routeurs avec lesquels ils sont appairés le ou les
sous-réseaux - le /surnetting/ s'applique ici - qu'ils sont en mesure de
router). On peut aussi utiliser BGP en interne d'un Système Autonome. On
parle alors d'/iBGP/.
Sélection de la meilleure route
Maintenant, comment ces protocoles choisissent-ils la meilleure route?
En attribuant une métrique aux différentes routes possibles entre le
point A et le point B, afin de pouvoir choisir (ou prédire quelle sera)
la meilleure route. Ces métriques sont déterminées par plusieurs
paramètres: la bande passante (vaut-il mieux que j'envoie ces
informations via une interface série ou via une interface fibre
optique?), le délai sur le réseau (ce routeur à côté ping à 200ms,
finalement je vais plutôt passer par un autre chemin), le nombre de
/hops/ (si je passe par là, je vais passer par 20 routeurs, alors que si
je prends ce chemin, je ne passe que par trois routeurs), la MTU du
lien, etc. La table de routage du routeur ne stocke que les meilleures
routes possible, là où les bases de données d'état de lien, ou
topologiques, peuvent stocker toutes les autres informations
disponibles (exemple d'une /fullview/ BGP, 1Go de RAM).
Dans le cas de routes identiques ou égales, il faut aussi être capable
de décider quelle route préférer, suivant les priorités suivantes:
- Longueur de Préfixe: on préfèrera toujours le préfixe le plus haut
(par exemple, on préfèrera utiliser la route qui annonce un /12 aux
routes qui annoncent 16 /16 de ce bloc), indépendamment du protocole de
routage dynamique utilisé. - Métrique: on préfèrera les routes avec la métrique la plus basse
(uniquement valable dans le cas où tous les routeurs utilisent le même
protocole de routage). - Distance Administrative: on utilisera les routes fournies par le
protocole considéré /le plus fiable/ - typiquement, utilisé dans les
routeurs Cisco.
Dans les grands (pensez à un IXP, un FAI, etc) Systèmes Autonomes, il y
a tellement de connexions entre différents routeurs, et ces connexions
étant amenées à souvent être modifiées, qu'il est quasiment impossible
pour un routeur de connaître la topologie complète du réseau, et encore
moins de déterminer quel est le meilleur chemin. Dans ce cas, on utilise
généralement le routage /next-hop/. Comme quoi plus c'est compliqué,
plus on retourne aux solutions simples 
BGP: Border Gateway Protocol
Principe de fonctionnement
/Border Gateway Protocol/ est un EGP utilisé... à peu près partout. Vous
en aurez besoin notamment si vous:
- Travaillez chez un opérateur
- Travaillez dans une TGE (très grande entreprise) et notamment dans son
/cœur de réseau/ - Gérez un point d'échange (IXP :p) entre opérateurs
BGP est un protocole utilisant TCP, sur le port 179. Pour établir une
relation de voisinage entre deux routeurs, il est nécessaire de la
configurer manuellement sur chaque routeur: BGP n'apprend pas "tout
seul" avec quels "voisins" discuter, notamment parce qu'en général, ces
"voisins" appartiennent à d'autres entreprises .
Création de la relation BGP
Lorsqu'une connexion BGP se crée, elle passe par plusieurs états:
- Idle :: C'est le premier stade, le routeur attend qu'on lui demande
d'ouvrir une session. Il va alors initier une session TCP avec son
"voisin", puis passer en mode Connect en attendant la réponse - Connect :: Le routeur attend la réponse SYN/ACK de son voisin, ainsi
qu'une demande de session TCP de ce même voisin: les deux routeurs
veulent établir une session en même temps. Une seule session sera
conservée (en général celle initiée par le routeur possédant la plus
haute /ID/, en général, la "plus grosse" adresse IP. Par exemple, si
20.0.0.1 cherche à établir une relation BGP avec son voisin 20.0.0.2,
c'est 20.0.0.2 qui sera le /chef/. Une fois qu'on a définit qui est le
patron, les routeurs envoient le message /Open/ et passent en mode /Open
Sent/. Note: Si la tentative de connexion échoue, le routeur passera
en mode Active et relance une nouvelle tentative d'établissement de la
session TCP. Si cette tentative échoue à nouveau, le routeur retourne en
mode Idle. - Open Sent :: La session TCP est créée, les deux routeurs se sont
communiqué différentes informations via le message /Open/: version de
BGP utilisée, ID du routeur (en général son IP), numéro d'AS, etc. Si
tout convient (versions du protocole compatibles, etc), le routeur
envoie alors un message /KeepAlive/ à son voisin et passe en mode /Open
Confirm/. - Open Confirm :: le routeur attend le message /KeepAlive/ de son voisin,
puis, une fois reçu, passe en mode /Established/ - Established :: Les deux routeurs sont désormais en mesure de s'échanger
des routes, la relation de voisinage est établie. On peut passer aux
choses sérieuses
Messages envoyés entre les peers
Une fois notre relation établie, BGP va envoyer différents types de
messages au routeur voisin:
- Keep Alive :: Permet de s'assurer que le routeur voisin est toujours
joignable. En règle générale, l'intervalle de temps entre deux Keep
Alive est d'un tiers du /Hold Down Timer/. Par défaut le /Hold Down
Timer/ chez Cisco est de 180 secondes, ce qui veut dire qu'on envoie un
Keep Alive toutes les 60 secondes. Si le Hold Down Timer est atteint et
qu'on n'a pas reçu de réponse à nos 3 Keep Alive, la relation de
voisinage est arrêtée. - Update :: permet d'annoncer de nouvelles routes, de supprimer
d'anciennes routes, etc. Lorsque BGP envoie une nouvelle route, il y
adjoint l'/AS Path/, qui permet d'indiquer quel chemin va emprunter le
paquet pour arriver à destination. Si le routeur "voisin" voit, dans cet
/AS Path/, son propre ASN, il refusera automatiquement la route pour
éviter une boucle de routage. - Notification :: Informe le voisin qu'il y a un problème. La relation BGP
ainsi que la session TCP entre les deux routeurs est interrompue, et
le(s) routeur(s) retournent en mode /Idle/.
Informations et tables stockées ou utilisées par BGP
BGP stocke les informations dans trois tables:
- Neighbor Table :: elle contient la liste des peers BGP avec lesquels le
routeur a établi une relation de voisinage. On peut vérifier ces
informations via la commande /show ip bgp summary/, cf screenshot
ci-dessous:
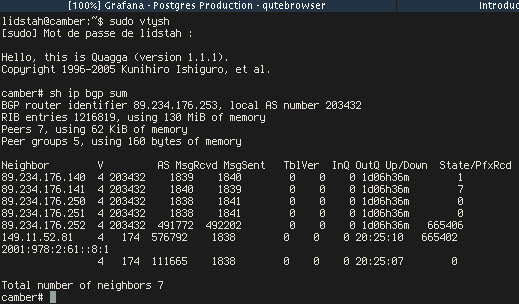
Ces relations sont identifiées par:
-
Neighbor :: l'ID du voisin
-
V :: la version de BGP utilisée
-
AS :: l'ASN du voisin
-
MsgRcvd :: le nombre de messages reçus (Update et KeepAlive)
-
MsgSent :: le nombre de messages envoyés (idem)
-
TblVer :: la dernière version des tables de routage envoyées
-
InQ :: le nombre de messages en file d'attente en provenance du voisin
-
OutQ :: le nombre de messages en file d'attente à envoyer au voisin
-
Up/Down :: l'/uptime/ de la session
-
State/PfxRcd :: le nombre de préfixes reçus par le voisin
-
BGP Table :: c'est la liste de toutes les routes reçues depuis tous les
voisins (il est en effet possible de recevoir la même route de plusieurs
voisins). Ici, je ne peux pas vous fournir de screenshot, car les
routeurs de tête de FAImaison ont une /Full View BGP/, c'est à dire que
leur table de routage contient les 665402 préfixes routés par tous les
AS de la planète et envoyés par notre fournisseur de transit, AS174,
Cogent. Un peu long à afficher. On peut vérifier l'état de cette
table avec la commande:
Router- show ip bgp
BGP table version is 1, local router ID is 10.0.0.1
#abreviations utilisees
   Network      Next Hop    Metric LocPrf Weight Path
*> 10.0.1.0/24  10.0.0.2         0           0          200 i
Les champs contenus dans cette table sont:
-
***: Signifie que la route est valide
-
>: Ici, le signe "plus grand que" signifie qu'il s'agit de la
meilleure route disponible -
Network: Le réseau de destination
-
Next Hop: Le prochain "saut" pour joindre le réseau de destination
-
Metric: La métrique du réseau
-
LocPrf: Préférence locale
-
Weight: Le poids donné à cette route
-
Path: Les AS par lesquels il faudra passer pour accéder au réseau de
destination, ici, un seul, AS200.
Et enfin la table de routage, qui se passe de commentaires
MultiHoming
Le MultiHoming, c'est être connecté à plusieurs FAIs ou transitaires (ou
peers). On bénéficie ainsi de redondance (haute disponibilité), et on
peut aussi faire de la répartition de charge.
C'est intéressant à la fois en entrée et en sortie:
En sortie, on peut répartir la charge sur les deux FAIs, voire choisir
le meilleur /AS Path/ vers Google ou Facebook (hum hum) en le favorisant
dans le choix du Next Hop. Sans BGP, on peut toujours faire de la
répartition de charge mais on ne peut pas connaître à l'avance le chemin
d'AS utilisé par chaque FAI.
En entrée, on peut, dans le cas d'une connexion avec deux FAIs,
répartir la charge en entrée, en annonçant la moitié de notre bloc à FAI
numéro 1, et l'autre moitié de notre bloc à FAI numéro 2.
eBGP
Imaginons que nous ayons trois AS, et trois routeurs de bordure (un par
AS):
- AS200, ayant une "patte" sur le réseau 172.16.1.0/24, et une connexion
directe avec AS100 via le sous-réseau 10.0.1.2/24 - AS300, ayant une "patte" sur le réseau 172.16.2.0/24, et une connexion
directe avec AS100 via le sous-réseau 10.0.2.2/24 - AS100, ayant une "patte" sur le sous-réseau 172.16.0.0/24, et une
connexion directe avec AS200 via 10.0.1.1/24 ainsi qu'une connexion
directe avec AS300 via 10.0.2.1/24
On arrive donc au schéma suivant:
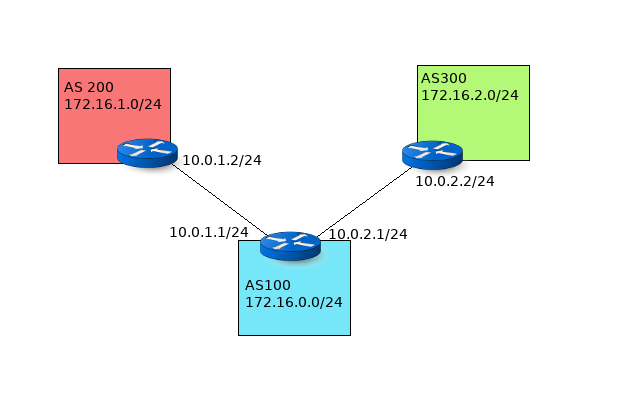
Le but va être de relier AS200 et AS300 à AS100. Chaque AS devra
annoncer le(s) sous-réseau(x) qu'il route en établissant des /relations
de voisinage/ avec son ou ses voisins, via les liens dont il dispose
(dans notre cas, un lien vers AS100 depuis AS200 et AS300 et 2 liens
vers AS200 et AS300 depuis AS100).
La configuration est très, très simple:
Création des relations eBGP entre nos AS
Sur le routeur AS200:
# dieze etant le caractere de commentaires...
RAS200(config)- router bgp 200
# On specifie l'IP du voisin et son ASN
RAS200(config-router)- neighbor 10.0.1.1 remote-as 100
Sur le routeur AS300:
# dieze etant le caractere de commentaires...
RAS300(config)- router bgp 300
# On specifie l'IP du voisin et son ASN
RAS300(config-router)- neighbor 10.0.2.1 remote-as 100
Sur le routeur AS100:
# dieze etant le caractere de commentaires...
RAS100(config)- router bgp 100
# On specifie l'IP des voisin et leurs ASN
RAS200(config-router)- neighbor 10.0.1.2 remote-as 200
RAS200(config-router)- neighbor 10.0.2.2 remote-as 300
Et... c'est presque tout! BGP étant un protocole par essence assez lent,
il faut attendre un peu que les infos "remontent".
Sur chaque routeur, on peut lancer la commande:
RASX- show ip bgp summary
Afin de voir le ou les voisins "remonter"
De même, on peut utiliser la commande:
RASX- show ip bgp neigh
Pour voir avec quels routeurs nous avons établi une session BGP. Bien
sûr, on peut ajouter l'adresse IP d'un /peer/ pour ne voir que la
relation établie avec ce routeur.
Les relations établies entre AS sont des relations eBGP, e pour
/exterior/. Bien sûr, il s'agit d'un setup extrêmement simple. Sur
Internet, par exemple, on risquerait aussi d'annoncer d'autres routes
(voire, toutes les routes vers Internet, la /fullview/ BGP) et donc, de
devenir /transitaire/ pour les AS avec lesquels on /peere/. Ce qu'on ne
veut pas forcément, voire, pas du tout.
Distribution de nos routes via la commande network
Alors c'est sympa, mais en fait, certes nos relations eBGP sont
établies, nos routeurs discutent, mais les routes vers les réseaux
internes (172.16.1/24, 172.16.2/24 et 172.16.0/24) de nos AS ne
remontent pas, par exemple sur une commande /show ip route/!
En effet, la commande /neighbor/ n'a fait qu'établir la relation BGP
entre nos routeurs de bordure, mais elle n'a pas établi quelles routes
de nos AS nous voulons transmettre à nos voisins eBGP! Pour pouvoir
indiquer ces réseaux, nous allons utiliser la commande /network/ sur
chacun de nos routeurs:
# sur le routeur AS200:
RAS200(config)- router bgp 200
RAS200(config-router)- network 172.16.1.0 netmask 255.255.255.0
# sur le routeur AS300:
RAS300(config)- router bgp 300
RAS300(config-router)- network 172.16.2.0 netmask 255.255.255.0
# Et enfin sur notre routeur AS100:
RAS100(config)- router bgp 100
RAS100(config-router)- network 172.16.0.0 netmask 255.255.255.0
Bien évidemment, si nous avons plus de routes à annoncer, il suffit
d'ajouter les commandes /network/ nécessaires et de laisser faire la
propagation BGP.
Distribution de nos routes via la redistribution de routes
Alors, la commande network, c'est sympa, mais on peut aussi utiliser la
redistribution de routes, par exemple pour le routeur AS200. On va
commencer par créer une access-list sur notre réseau. Bien retenir
qu'ici, on ne renseigne pas le masque de sous-réseau, vu que nous
utilisons une access-list, mais le wildcard!
RAS200(config)- access-list 10 permit 172.16.1.0 0.0.0.255
RAS200(config)- route-map AS200BGPRedis
RAS200(config-route-map)- match ip address 10
# on revient en mode conf term:
RAS200(config)- router bgp 200
RAS200(config-router)- redistribute connected route-map AS200BGPRedis
Ici, on voit que si on ajoute de plus en plus de réseaux, il suffit de
les ajouter à notre access-list pour qu'ils soient automatiquement
redistribués aux autres routeurs! (testez avec 2/3 sous-réseaux sur des
interfaces /loopback/)
/Anecdote/: un FAI pakistanais (en 2008 ou 2009 de mémoire) voulait
bloquer Youtube sur injonction gouvernementale, et au lieu d'annoncer
les ASN utilisés par Youtube en interne, afin de rediriger les
utilisateurs pakistanais vers une page de censure à la c.. les a...
annoncés à l'extérieur! Et comme leurs routeurs de bordure étaient
considérés comme étant de confiance par les autres FAIs et transitaires
de la région, qui eux mêmes étaient aussi considérés de confiance par
les autres FAIs et transitaires mondiaux, le Pakistan s'est retrouvé
avec tout le trafic mondial à destination de Youtube dans ses tuyaux 
(tout en privant la planète de Youtube pendant environ 7 heures). GG la
censure, non? Moi j'appelle ça un joli retour de bâton
iBGP
On vient de voir comment annoncer et recevoir des routes (ne pas oublier
que BGP ne /route/ pas, il ne fait qu'/annoncer/ des routes) entre nos
Systèmes Autonomes.
Comment faire pour annoncer ces routes /à l'intérieur/ de notre Système
Autonome?
On va, dans ce cas, utiliser iBGP.
Prérequis
Imaginons le /setup/ suivant:
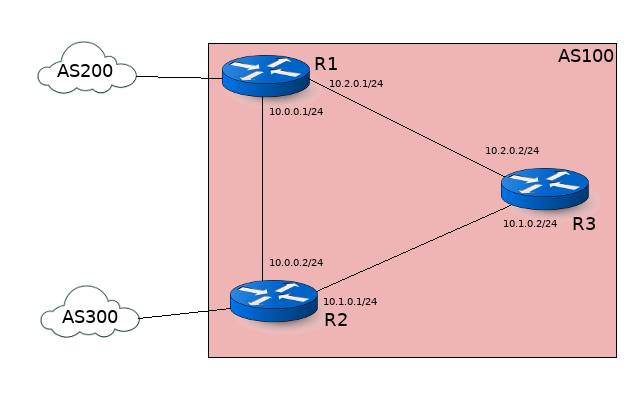
Nous sommes l'AS 100, nous avons un routeur (R1) connecté à l'AS 200, et
un routeur (R2) connecté à l'AS 300. Les relations eBGP sont déjà
établies entre nos routeurs R1 et R2 et les routeurs de bordure de leurs
AS respectifs. Un troisième routeur (R3) dispose d'un lien avec R1 et
R2, et R1 et R2 sont connectés entre eux.
À première vue, le plus simple serait de mettre en place une relation
iBGP entre R1 et R2 sur leurs interfaces physiques assurant
l'interconnexion entre R1 et R2 sans se soucier de R3. On peut le faire,
ça fonctionnera. Mais que se passe-t-il si jamais le lien entre R1 et
R2 est coupé? Notre relation iBGP ne fonctionnera plus, même si R1 peut
joindre R2 via R3 et vice-versa.
(bien évidemment, on pourrait utiliser des /30 entre nos routeurs...)
Mise en place
Dès lors, on va utiliser des interfaces de /loopback/. On va donc
ajouter, sur R1 et R2, une interface de loopback avec les adresses IP
suivantes:
Sur R1: 10.3.0.1/32
Sur R2: 10.4.0.1/32
via les commandes suivantes (pensez à ajouter les routes nécessaires sur
R1, R2, et R3 - on fera ça en OSPF pendant les TPs):
# evidemment, utiliser une interface loopback qui ne soit pas deja config
# sur R1:
R1(config)- interface loopback 0
R1(config-if)- ip address 10.3.0.1 255.255.255.255
# sur R2:
R2(config)- interface loopback 0
R2(config-if)- ip address 10.4.0.1 255.255.255.255
On va ensuite configurer la relation BGP entre nos deux routeurs:
# sur R1
R1(config)- router bgp 100
R1(config-router)- neighbor 10.4.0.1 remote-as 100
# sur R2
R2(config)- router bgp 100
R2(config-router)- neighbor 10.3.0.1 remote-as 100
Si on effectue un /show ip bgp summary/ (qu'on doit pouvoir abréger en
sh ip bgp sum ), on va voir que notre relation BGP n'est pas UP.
Pourquoi? On "ping" bien nos interfaces loopback depuis nos autres
routeurs, non?
Eh bien en fait, quand R1 va envoyer un message à R2, l'ip source de ce
message ne sera pas 10.3.0.1/32 mais soit 10.0.0.1 soit 10.2.0.1 (si le
lien R1 <-> R2 est coupé et qu'on passe par R3). Or R2 s'attend à
recevoir les messages iBGP de R1 via son interface 10.3.0.1 - et donc,
comme BGP est bien fait (si si), il ignorera ce message.
Il va donc falloir modifier l'adresse IP /source/ lorsqu'on envoie nos
messages BGP entre nos deux routeurs. C'est très simple:
# sur R1:
R1(config-router)- neighbor 10.4.0.1 update-source loopback 0
# et vous l'aurez deja devine, mais pour R2:
R2(config-router)- neighbor 10.3.0.1 update-source loopback 0
Autre petit détail:
Vous avez peut être ajouté les routes statiques de cette façon:
# On prend l'exemple de R1 ici
R1(config)- ip route 10.4.0.1 255.255.255.255 10.0.0.2
# et la route de backup en ajoutant une metrique plus elevee
R1(config)- ip route 10.4.0.1 255.255.255.255 10.2.0.2 250
Hors si on coupe le lien R1-R2, ça ne fonctionne pas - les routes
statiques sont /récursives/ et si le lien tombe, la route de backup
n'est pas utilisée. Il faut donc spécifier l'interface utilisée
directement (ici, on va dire Fa1/0) dans notre première route - ainsi,
si le lien tombe sur Fa1/0 notre route de secours sera utilisée
# Note: sur un lien PPP (serial par ex) on effacera l'ancienne route,
# sur du lien Ethernet on conserve la route avec le next-hop
# on ajoute la regle correcte
R1(config)- ip route 10.4.0.1 255.255.255.255 Fa1/0
Et idem sur les autres routeurs
Par contre, si eBGP modifie le /next-hop/ par son adresse, iBGP ne
modifie pas le next-hop, et donc, dans notre exemple, R1 ne transmettra
pas les bonnes informations de passerelle d'AS200 (ie, lui même) à R2,
et inversement: si les routes apparaissent bien dans la table de routage
de R1 ou R2, R1 n'a aucune idée de comment joindre la passerelle
d'AS300. Afin de palier à ce problème, on va ajouter la directive
/next-hop-self/:
# ici pour R1:
R1(config-router)- neighbor 10.4.0.1 next-hop-self
# a effectuer sur R2 aussi :)
Avancé
Peer Groups
Lorsqu'on /peere/ avec plusieurs AS, on peut vouloir filtrer ce qu'on
annonce ou ce qu'on reçoit de tel ou tel peer. Pour ça, on peut
regrouper nos peers dans des /peer-groups/ auxquels on va attribuer un
numéro ou - plus pratique à mon avis - des noms. Admettons que nous
ayons une relation BGP déjà établie avec 20.20.20.20 et 30.30.30.30, et
qu'on veuille les regrouper dans le /peer-group/ TRANSIT:
# on declare notre peer-group
Router(config-router)- neighbor TRANSIT peer-group
# on ajoute nos peers a ce groupe:
Router(config-router)- neighbor 20.20.20.20 peer-group TRANSIT
Router(config-router)- neighbor 30.30.30.30 peer-group TRANSIT
Ensuite, nous pourrons par exemple envoyer notre liste de préfixes
/announce-out/ (cf point suivant) à nos peers de notre groupe TRANSIT:
Router(config-router)- neighbor TRANSIT prefix-list announce-out out
Liste de préfixes
Dans le précédent point, nous avons vu les liste de contrôle d'accès
(access-list) ainsi que la commande route-map.
On peut aussi utiliser des listes de préfixes /prefix-list/ afin de
déterminer ce que nous voulons recevoir et transmettre via BGP.
Typiquement, dans le monde réel (c'est à dire sur Internet), en sortie
de notre AS, nous ne voudrons annoncer que nos sous-réseaux publics. De
même, nous ne voulons pas qu'un petit malin se mette à annoncer des
routes n'existant pas depuis notre réseau. Pour cela, nous allons créer
une prefix-list, que nous allons appeler announce-out (mais on peut
l'appeler comme on veut, même si c'est quand même mieux que le nom soit
compréhensible ). On se place en mode configuration de notre routeur.
On part du principe que nous voulons annoncer le réseau 90.80.70.0/24 à
nos peers BGP:
# on autorise l'annonce de notre sous-reseau
Router(config)- ip prefix-list announce-out seq 5 permit 90.80.70.0/24
# on deny tout le reste (notez le numero de sequence, on se reserve de la place au cas ou on aurait d'autres reseaux a annoncer par la suite)
Router(config)- ip prefix-list announce-out seq 100 deny any
De même, il existe des routes qu'on ne désire pas recevoir, typiquement:
- Les réseaux RFC 1918: 10/8, 172.16/12, et 192.168/16
- Les réseaux réservés: 0.0.0.0/8 (réservé pour le broadcast et le
software), 0.0.0.0/0 (idem), multicast (224/4), expérimental (240/4),
AVAHI/APIPA (169.254/16), lien local (127/8) - Les réseaux réservés à la documentation, à DS Lite ou aux tests réseau:
192.0.0.0/24 (DS Lite, du NAT en gros), 192.0.2.0/24 (TEST-NET-1, pour
la documentation et exemples), 198.18/16 (utilisé pour tester la
communication entre réseaux), 198.51.100/24 (TEST-NET-2) et
203.0.113.0/24 (TEST-NET-3) - Carrier Grade NAT: 100.64.0.0/10
Une liste de préfixes les prenants tous en charge et nommée
"transit-in":
ip prefix-list transit-in seq 5 deny 0.0.0.0/0
ip prefix-list transit-in seq 10 deny 0.0.0.0/0 le 8
ip prefix-list transit-in seq 12 permit 23.128.0.0/10 ge 24 le 28
ip prefix-list transit-in seq 15 deny 0.0.0.0/0 ge 25
ip prefix-list transit-in seq 20 deny 0.0.0.0/8 le 32
ip prefix-list transit-in seq 25 deny 10.0.0.0/8 le 32
ip prefix-list transit-in seq 30 deny 100.64.0.0/10 le 32
ip prefix-list transit-in seq 35 deny 127.0.0.0/8 le 32
ip prefix-list transit-in seq 40 deny 169.254.0.0/16 le 32
ip prefix-list transit-in seq 45 deny 172.16.0.0/12 le 32
ip prefix-list transit-in seq 50 deny 192.0.0.0/24 le 32
ip prefix-list transit-in seq 55 deny 192.0.2.0/24 le 32
ip prefix-list transit-in seq 60 deny 192.168.0.0/16 le 32
ip prefix-list transit-in seq 65 deny 198.18.0.0/15 le 32
ip prefix-list transit-in seq 70 deny 198.51.100.0/24 le 32
ip prefix-list transit-in seq 75 deny 203.0.113.0/24 le 32
ip prefix-list transit-in seq 80 deny 224.0.0.0/4 le 32
ip prefix-list transit-in seq 85 deny 240.0.0.0/4 le 32
ip prefix-list transit-in seq 90 permit any
On autorise 23.128.0.0/10, il s'agit d'un réseau réservé pour faciliter
le déploiement d'IPv6. les paramètres ge 24 et le 28 indiquent que le
bloc le plus petit assignable à l'intérieur de ce sous-réseau est un
slash 28, et le plus grand assignable est un slash 24. Si on /peere/
avec un FAI/Opérateur de transit, il nous transmettra l'intégralité de
sa table de routage, c'est à dire l'intégralité de la table de routage
BGP d'Internet (v4). C'est ce qu'on appelle une /full view BGP/. Comptez
un bon GiB de RAM pour ça - donc à ne pas faire sur un routeur un
peu vieux ne disposant pas de ces ressources de mémoire vivre.
Pour appliquer ces règles aux routes communiquées par nos /peers/, il
suffit juste d'ajouter la règle correspondante dans notre configuration
BGP:
Router(config-router)- neighbor TRANSIT prefix-list transit-in in
De la même manière, des blocs d'adresses IPv6 sont réservés:
- les adresses réservées aux logiciels ou à l'hôte: ::/128 (Software,
adresse non spécifiée, similaire à 0.0.0.0/0), ::1/128 (localhost),
2001:20::/28 (ORCHIDv2)
- Le bloc réservé à la translation d'adresses IPv4/IPv6: 64:ff9b::/96 (RFC 6052)
- 100::/64: RFC 6666, le "Discard Prefix" (ie, le "blackhole" vers lequel
envoyer les DDoS) - Le tunneling Teredo: 2001::/32
- Les adresses réservées à la documentation: 2001:db8::/32
- Le bloc réservé au 6to4: 2002::/16
- Et enfin les adresses de lien local et de multicast: fc00::/7, fe80::/10
et ff00::/8 pour le multicast.
Et la prefix-list "qui va bien©":
ipv6 prefix-list ipv6-ebgp-relaxed seq 5 deny 3ffe::/16 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 10 deny 2001:db8::/32 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 15 permit 2001::/32
ipv6 prefix-list ipv6-ebgp-relaxed seq 20 deny 2001::/32 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 25 permit 2002::/16
ipv6 prefix-list ipv6-ebgp-relaxed seq 30 deny 2002::/16 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 35 deny ::/8 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 40 deny fe00::/9 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 45 deny ff00::/8 le 128
ipv6 prefix-list ipv6-ebgp-relaxed seq 50 permit 2000::/3 le 48
ipv6 prefix-list ipv6-ebgp-relaxed seq 55 deny ::/0 le 128
Ce qui me permet d'astucieusement transitionner sur... IPv6 et BGP
IPv6
La configuration est très similaire à celle d'IPv4, imaginons que nous
voulons établir une relation BGP avec l'AS 174, pour annoncer notre
réseau IPv6 2a00
nous allons nous appairer est 2001:978:10:250::af:1, que nous allons
assigner au groupe TRANSIT-V6:
Router(config-router)- neighbor TRANSIT-V6 peer-group
Router(config-router)- neighbor 2001:978:10:250::af:1 remote-as 174
Router(config-router)- neighbor 2001:978:10:250::af:1 peer-group TRANSIT-V6
Router(config-router)- address-family ipv6
Router(config-router)- network 2a00:af80:1000::/40
Router(config-router)- neighbor 2001:978:10:250::af:1 activate
Router(config-router)- exit-address-family
Router(config-router)- exit
Et appliquer notre liste de préfixes ipv6-ebgp-relaxed décrite plus haut
à notre groupe TRANSIT-V6:
Router(config-router)- neighbor TRANSIT-V6 prefix-list ipv6-ebgp-relaxed in
Spécificités liées à Internet
De même, en général, sur Internet, il sera nécessaire d'utiliser la
directive /next-hop-self/, le réseau que nous annonçons n'étant pas
celui avec lequel nous nous interconnectons avec notre peer BGP:
Router(config-router)- neighbor TRANSIT next-hop-self
De même, lorsqu'une route sera modifié "de l'autre côté", c'est à dire
du côté de notre opérateur (ou de nos opérateurs), on ne veut pas avoir
à relancer la session BGP pour que cela soit pris en compte. On va donc
activer (normalement activé par défaut sur du matériel récent) la
soft-reconfiguration en /inbound/, c'est à dire en entrée de notre
réseau:
Router(config-router)- neighbor TRANSIT soft-reconfiguration inbound
De même, nous ne voulons pas transmettre nos règles et modifications
iBGP à l'extérieur. On va se créer un peer group IBGP-NOEXPORT, et la
prefix-list correspondante:
Router(config)- ip prefix-list export-nothing seq 5 deny any
# Puis on l'applique a notre peer group:
Router(config-router)- neighbor IBGP-NOEXPORT prefix-list export-nothing out
Métrique BGP
Alors, là, on va rentrer dans le - relativement - complexe. En effet, si
on a vu précédemment les 3 métriques classiques des algorithmes de
routage dynamique, il faut savoir que BGP propose... 14 métriques
différentes. Oui, ça pique. Et... non, on ne s'en sert pas souvent dans
une utilisation "classique". Par contre, il peut parfois être pertinent
de jouer sur ces métriques afin d'obtenir les meilleures performances
pour notre AS, même si en règle générale les métriques Next-Hop, AS Path
et MED sont suffisantes. Pour résumer, rien de tel qu'un petit tableau!
| Numéro | Attribut | Catégorie | Préférence | Description |
|---|---|---|---|---|
| 0 | Next-Hop | Mandataire | On ignore les routes dont le | |
| next-hop est inaccessible | ||||
| 1 | Weight | Optionnelle | Le plus haut | permet de favoriser un voisin |
| 2 | Local Preference | Discrète | Le plus haut | Métrique appliquée sur une |
| route annoncée dans l'AS (iBGP) | ||||
| 3 | Self Originated | Favoriser les routes annoncées par | ||
| le routeur lui même | ||||
| 4 | AS Path | Mandataire | Le plus court | Choisir la route passant par |
| le moins d'AS | ||||
| 5 | Origin | Mandataire | IGP<EGP<? | Préfère une route IGP par rapport |
| à une route eBGP | ||||
| 6 | MED | Optionnelle | Le plus bas | Permet d'influencer le choix du |
| routeur pour rentrer dans l'AS | ||||
| 7 | BGP AD | eBGP | Préfère une route apprise par eBGP | |
| 8 | IGP Cost | La plus basse | Choisi la route iBGP la plus | |
| courte vers le next-hop | ||||
| 9 | Multipath | Détermine si plusieurs routes | ||
| doivent être installées | ||||
| pour faire du multipath | ||||
| 10 | Age | La plus ancienne | Ne pas remplacer une route | |
| par une nouvelle si égalité | ||||
| à la 9ème métrique | ||||
| même si 11,12,13 sont meilleures | ||||
| 11 | Router ID | Optionnelle | Le plus bas | Choisit la route venant |
| du routeur avec l'ID le plus bas | ||||
| 12 | Originator ID | Optionnelle | Le routeur ignore la route si | |
| elle provient de lui même | ||||
| 13 | Neighbor Address | La plus basse | Choisir la route venant du | |
| voisin avec l'IP la plus faible |
On peut agir sur les métriques dans notre configuration BGP:
En modifiant le poids d'une route sur un routeur (weight, propriétaire
Cisco - moche, donc - n'impacte pas les autres routeurs du réseau):
Router(config-router)- neighbor A.B.C.D weight 50
En modifiant la /Local Preference/ pour "favoriser" le choix d'un
routeur par les autres routeurs de notre réseau:
# La local-preference par defaut est de 100
Router(config-router)- bgp default local-preference 200
En utilisant la MED (/Multi-Exit-Discriminator/) pour laquelle il faut
créer une route-map sur certains réseaux annoncés et y appliquer une
métrique:
# on cree d'abord une access-list sur le reseau concerne:
Router(config)- access-list 1 permit A.B.C.D WildC.A.R.D
# puis on cree la route-map:
Router(config)- route-map MaRouteMap
Router(config-route-map)- match ip address 1
Router(config-route-map)- set metric 200
# pour ne pas bloquer l'annonce des autres reseaux, on cree une regle permit vide:
Router(config)- route-map MaRouteMap permit 20
Router(config-route-map)- exit
# Et on a plus qu'a appliquer la route map (par ex AS300 ici):
Router(config)- router bgp 300
Router(config-router)- neighbor W.X.Y.Z route-map MaRouteMap out
Ouf!
Authentification MD5 pour BGP
Revenons sur notre schéma précédent. Si nous voulons mettre en place
l'authentification md5 (/shrug/) entre nos /peers/ BGP à l'intérieur de
notre AS100, nous avons simplement à ajouter ces éléments de
configuration sur chaque routeur et pour chaque /peer iBGP/, ici pour
R1:
R1(config)- router bgp 100
R1(config)- neighbor 10.4.0.1 password BGPcestcool
# on procede de meme pour R2
Eeeet... voilà . En général, chez un transitaire/en DC/colo, et
lorsqu'on /peere/ en eBGP, les deux parties se mettront d'accord sur la
clef de chiffrement à utiliser. Une autre procédure est d'utiliser
l'adresse MAC de l'interface d'interco du routeur d'en face pour "être
sûr" (/cough, cough/) qu'il s'agit bien de cette machine. La dernière
solution: utiliser un câble, un seul, pas de switch, qui passera par le
plancher ou le plafond techniques pour connecter directement nos
interfaces en Point à point.
On a normalement fait le tour des possibilités offertes par BGP - le TP
à venir nous montrera si j'ai oublié quelque chose de toute façon . On
peut passer à OSPF!
OSPF: Open Shortest Path First
Principe de Fonctionnement
Définitions, topologie, areas
Tout d'abord, OSPF est un IGP dit à /état de lien/, ce qui signifie que
tous les routeurs du réseau connaissent la topologie complète du réseau
en question. À partir de cette topologie et des caractéristiques des
liens établis à l'intérieur du réseau (liaison série, liaison
FastEthernet, GigabitEthernet, Fibre optique, etc), nos routeurs peuvent
choisir le meilleur chemin pour chaque destination du réseau interne.
Nos routeurs déterminent donc la meilleure route en fonction de ces deux
paramètres:
- Topologie du réseau
- Vitesse des liens
En utilisant l'algorithme de Dijkstra (s'il y a des matheux ou matheuses
ici... faites vous plaisir avec l'article Wikipedia qui décrit cet
algorithme ), nos routeurs vont attribuer un /coût/ à chaque lien, et
déterminer le plus court chemin en fonction de ces coûts. Ces coûts
constituent la /métrique/ utilisée par OSPF.
De même, OSPF introduit la notion de zones (/areas/, aussi appelées
aires), dans le but d'alléger le processus (coûteux en terme de temps
CPU) des routeurs de notre réseau interne. Au sein d'une même /area/,
tous les routeurs se connaissent, c'est à dire qu'ils se partagent les
informations sur leurs états de liens. Entre aires, les routeurs n'ont
connaissance que des routes disponibles. Par exemple, un routeur de
l'area 0 (dite /backbone/) connaîtra l'état des autres routeurs de la
zone 0, mais ne connaîtra que les routes et réseaux disponibles dans
l'area 1: il ne connaîtra pas l'état des liens dans la zone 1.
On distingue plusieurs types de routeurs OSPF:
- Les routeurs internes: ce sont des routeurs dont toutes les interfaces
sont dans la même aire OSPF - Les /Area Border Router/, ABR, qui disposent d'interfaces dans des aires
différentes. Un routeur ayant une "patte" dans l'aire 0 et une autre
dans l'aire 1 est un ABR. C'est aussi un routeur /backbone/, cf plus
bas. - Les /Autonomous System Boundary Router/, ASBR, sont des routeurs qui
injectent dans OSPF des routes provenant d'autres protocoles de routage
(au hasard, BGP), ou des routes statiques. - Les Routeurs /backbone/ sont des routeurs dont au moins une interface
appartient à la zone 0. Typiquement, tous les ABR sont des routeurs
backbone.
Si on regarde le schéma suivant:
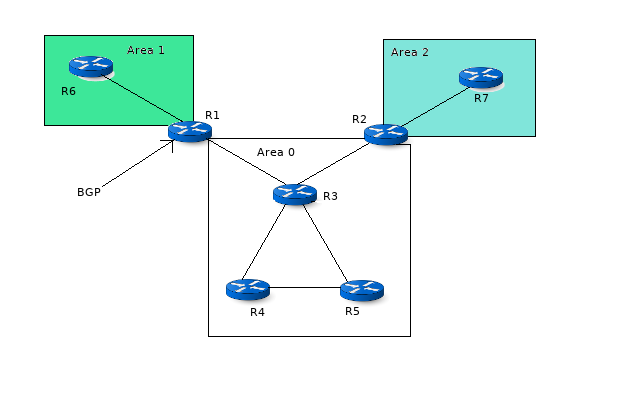
Ici, R1 et R2 sont à la fois des routeurs Backbone et des routeurs
ABR. R1, vu qu'il injecte des routes apprises par BPG, est aussi un
ASBR.
R3, R4 et R5 sont des routeurs Backbone (ils appartiennent à l'aire 0)
et des routeurs internes (ils ne sont pas connectés à d'autres aires).
R6 et R7 sont des routeurs internes: ils appartiennent respectivement
à la zone 1 et à la zone 2, mais n'ont pas d'interface vers d'autres
zones.
Idéalement, on résumera les routes qu'on annonce entre aires
(surnetting). L'organisation en aires permet de réduire la taille de la
topologie que chaque routeur de chaque zone doit connaître, ce qui
permet d'alléger le processus OSPF de chaque routeur de chaque aire.
Les aires sont identifiées sur 32 bits, et exprimées soit en décimal
soit sur le même principe que les adresses IPv4 (32 bits, 8 bits séparés
par des points). Par exemple, la zone 0 peut aussi être la zone 0.0.0.0
(par convention). Cela signifie que notre zone 1 pourrait aussi être la
zone 172.16.0.1 si R1 avait cette adresse IP et qu'on avait décidé de
l'appeler ainsi. Ou on aurait pu la nommer zone 1.1.1.1. Attention, ça
peut parfois porter à confusion lorsqu'on met en place un réseau OSPF ou
lorsqu'on intervient sur un réseau déjà en place. Il est donc important
de bien établir une convention de nommage de nos aires en fonction de ce
qui sera le plus pratique pour les administrateurs (en général, en
fonction de la complexité du réseau).
Attention: Toutes les zones doivent être connectées à l'aire 0. La
topologie des aires est donc de type étoile.
Pour réduire le trafic entre les routeurs, les routeurs d'une aire
désignent un /Designated Router/ ainsi qu'un /Backup Designated Router/.
Lorsqu'on parle de DR et de BDR, on parle en fait des attributs d'une
interface réseau des routeurs en question.
- Un /Designated Router/, c'est l'interface d'un routeur qui a été élue
parmi tous les routeurs de l'aire. Il s'agit du routeur dont l'interface
à la priorité la plus haute, ou le router ID le plus haut, ou dont
l'adresse IP est la plus haute. La façon dont un DR est élu dépend de
l'implémentation. Typiquement, l'implémentation Cisco et
l'implémentation ospfd pourraient donc potentiellement élire des DR
différents. - Un /Backup Designated Router/ est un routeur qui a été élu selon les
mêmes principes que le DR pour devenir DR si le DR actuel rencontre un
problème quelconque (panne, câble arraché par un chaton, etc).
Deux routeurs OSPF sont /voisins/ s'ils sont:
- Membres du même sous-réseau, avec le même masque de sous-réseau
- Ont la même ID de zone, c'est à dire qu'ils appartiennent à la même
/area/ - Ont les mêmes timers (cf section suivante)
- Ont le même mot de passe (si mis en place)
Les voisins OSPF ne partagent pas d'informations de routage, ils
échangent juste des paquets Hello. Pour que deux voisins OSPF deviennent
adjacents et puissent s'échanger des routes, ils doivent d'abord:
- Être voisins
- Un des routeurs est un DR ou un BDR
- Ou être connectés en Point-to-Point (ou Point to Multipoint)
Comment OSPF communique
OSPF utilise des paquets /Hello/ pour découvrir et entretenir ses
relations de voisinage. Ces paquets sont envoyés toutes les 10 secondes
en multicast vers l'adresse 224.0.0.5 (IPv6: ff02::5). L'adresse
224.0.0.6 (IPv6: ff02::6) est réservée aux les /Designated Routers/ et
BDR. Si un voisin ne répond pas à 4 /Hellos/ successifs, le voisin est
considéré comme étant DOWN.
Un paquet /Hello/ contient:
- l'ID du routeur
- Le masque de sous-réseau
- l'ID de l'aire
- L'incrément/timers Hello/Dead
- La liste des voisins
- La priorité du routeur (le réseau "élit" un /Designated Router/ (DR) et
un /Backup Designated Router/ (BDR) - Les adresses IP du DR et du BDR.
- Le mot de passe OSPF (si ça a été configuré, on y revient dans la suite
)
Dans nos paquets HELLO, les champs masque de sous-réseau, ID de la zone,
timers et le mot de passe doivent correspondre, sinon, la mise en
relation n'est pas possible.
Chaque routeur dispose d'une /DataBase Description/, DBD, qui résume
tous les liens connus par le routeur. Lorsqu'un routeur découvre un lien
qui n'est pas connu de la DBD, il demande des informations sur ce lien
via un message /LSR/, Link State Request.
-
Un LSR permet donc de demander des informations sur un lien. La réponse
est un /Link State Advertisement/, LSA. -
Un LSA contient les informations du lien, qui peut être de plusieurs
types: -
Type 1: Décrit les interfaces d'un routeur voisin.
-
Type 2: Décrit les routeurs connectés au segment. Ce message est
envoyé par le DR en multicast (224.0.0.6 et ff02::6). -
Type 3: Résumé de route envoyé dans une autre aire par un ABR
-
Type 4: Décrit un ASBR, envoyé dans d'autres aires.
-
Type 5: Les routes redistribuées par l'ASBR (BGP, EIGRP, etc)
-
Type 7 (oui oui): comme le type 5 mais pouvant circuler sur une
/Not So Stubby Area/, NSSA, on y reviendra plus tard et notamment dans la pratique en TP.
Un message /Link State Update/ LSU contient plusieurs LSA.
Et enfin, un message /LSAck/ est un accusé de réception des messages
précédents (DBD, LSR, LSA et LSU) sauf le HELLO qui n'a pas d'ACK.
Étapes de mise en relation de voisinage OSPF
Attention, ça va piquer!
Il y a huit étapes dans l'établissement d'une relation entre deux
routeurs OSPF. Ces étapes sont:
- Première étape :: déterminer son router ID. En général, soit le router ID
est déterminé manuellement, soit il s'agit de l'IP la plus haute d'une
interface de /loopback/, soit il s'agit de l'IP la plus haute d'une
interface physique, soit... hum, comment communiquer sans liaison
physique? - Seconde étape :: Ajout des interfaces sur lesquelles envoyer le message
HELLO (on verra ça dans la prochaine section) - Troisième étape :: envoi des messages HELLO
- Quatrième étape :: Réception d'un HELLO (si tout est correctement
configuré) - Cinquième étape :: Envoi d'un message REPLY HELLO si le routeur reçoit un
message HELLO dans lequel il est déjà inclus (dans la liste des
/neighbor/), cela signifie qu'il est déjà connu de son voisin. L'envoi
de ce message REPLY HELLO permet de remettre le compteur Dead Timer du
voisin à 0, et on s'arrête là. Sinon, cela signifie que les deux
routeurs ne se connaissent pas et on passe à l'étape 6. - Sixième étape :: Détermination de la relation /Master/Slave/ entre les
deux routeurs voisins. Le routeur ayant la plus haute priorité "gagne"
le statut de Master. Sinon, le routeur ayant la plus haute Router ID
devient le Master. Le Master envoie ensuite sa /DataBase Description/,
DBD. - Septième étape :: à partir des résumés de la DBD, chaque routeur détermine
ce que son voisin connaît et qu'il ne connaît pas, puis demande via des
messages /Link State Request/, LSR, au Master de lui envoyer ces
détails. Le Master répond ensuite par un ou plusieurs LSU (/Link State
Update/). Ensuite, c'est au Master d'envoyer des LSR au slave qui lui
répondra par des LSUs. C'est ici que s'effectue la convergence des
données des DBD de chaque routeur. Après chaque message, on envoie des
LSAck pour accuser la réception des précédents messages. - Huitième étape :: Les voisins sont synchronisés. À ce moment, le Master
connaît les routes que peut annoncer le Slave et inversement.
États d'une relation de voisinage OSPF
Une relation de voisinage OSPF va passer par plusieurs états:
- Down :: On essaie de joindre nos voisins
- Initialisation :: Le HELLO a été reçu, mais notre routeur n'apparaît pas
encore dans la liste des /neighbors/, voisins, de son voisin - 2-Way :: La relation est créée. À ce moment, si nécessaire, on élit DR et
BDR. - Exchange :: On procède à l'échange des DBD de chaque routeur
- Loading :: C'est l'étape pendant laquelle sont échangés les LSU et LSR
entre le Master et le Slave. - Full :: les deux DBD des routeurs sont désormais synchronisées.
Mais au fait, pourquoi on élit un DR et un BDR?
Sur un lien point à point, le routeur ayant la priorité, ou l'id, ou
l'adresse IP la plus haute sera nécessairement le DR et son voisin le
BDR. Cependant, sur un réseau dit /MultiAccess/, c'est à dire, par
exemple, un réseau où plusieurs routeurs sont connectés au même switch,
si chaque routeur transmettait l'intégralité de sa DBD à tous les autres
routeurs, puis les LSR, LSU, et LSAck nécessaires, on pourrait, suivant
le nombre de routeurs sur le réseau, engorger nos liens avec des
messages broadcastés/multicastés assez rapidement (pensez à une boucle
de broadcast sur des switches sans Spanning Tree Protocol: c'est un peu
la même).
Ainsi, sur ce type de réseau, si un routeur souhaite envoyer une mise à
jour de sa DBD (LSU), il l'enverra uniquement au DR et au BDR (sur l'ip
multicast 224.0.0.6 ou ff0b::6 en IPv6). Le DR la redistribuera ensuite
à tous les autres routeurs de la zone (en multicast sur 224.0.0.5 /
ff0b::5).
Seuls le DR et le BDR ont une relation qualifiée de /Full/. Les autres
membres de la communauté OSPF sont appelés des /DROthers/, et leur
relation reste en /Two-Way/.
Configuration de base
Reprenons notre schéma précédent et ajoutons des sous-réseaux que nous
allons pouvoir annoncer via OSPF:
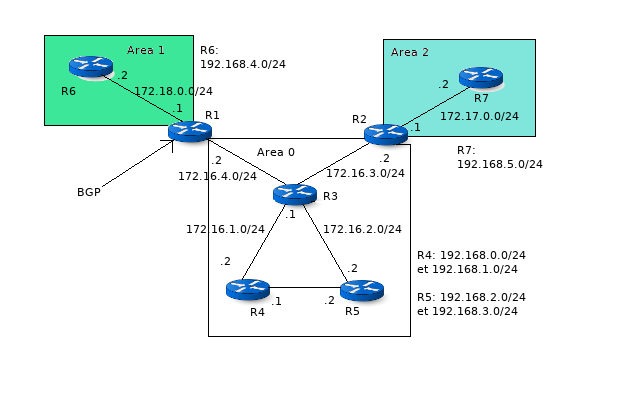
(oui, je suis nul en dessin  )
On va d'abord configurer notre Area 0:
configuration de l'Aire 0
Commençons par configurer R1, qui sera notre ABR entre l'aire 0 et
l'aire 1, uniquement sur l'aire 0:
# le '1' apres ospf indique l'id de processus. on peut activer plusieurs processus ospf
# sur le routeur mais dans notre cas on utilisera seulement le processus 1.
R1(config)- router ospf 1
R1(config-router)- router-id 1.1.1.1
# ici, on ne va annoncer que l'ip de R1, pas tout le sous-reseau, donc wildcard de /32
R1(config-router)- network 172.16.4.2 0.0.0.0 area 0
Puis R2, de la même façon:
# le '1' apres ospf indique l'id de processus. on peut activer plusieurs processus ospf
# sur le routeur mais dans notre cas on utilisera seulement le processus 1.
R2(config)- router ospf 1
R2(config-router)- router-id 2.2.2.2
# ici, on ne va annoncer que l'ip de R2, pas tout le sous-reseau, donc wildcard de /32
R2(config-router)- network 172.16.3.2 0.0.0.0 area 0
Puis R3, qui va être un peu plus long à configurer.
R3(config)- router ospf 1
R3(config-router)- router-id 3.3.3.3
R3(config-router)- network 172.16.1.1 0.0.0.0 area 0
R3(config-router)- network 172.16.2.1 0.0.0.0 area 0
R3(config-router)- network 172.16.3.1 0.0.0.0 area 0
R3(config-router)- network 172.16.4.1 0.0.0.0 area 0
Puis finalement, R4, puis R5. Pour R4:
R4(config)- router ospf 1
R4(config-router)- router-id 4.4.4.4
R4(config-router)- network 172.16.1.2 0.0.0.0 area 0
R4(config-router)- network 192.168.0.0 0.0.0.255 area 0
R4(config-router)- network 192.168.1.0 0.0.0.255 area 0
Et finalement R5:
R5(config)- router ospf 1
R5(config-router)- router-id 5.5.5.5
R5(config-router)- network 172.16.2.2 0.0.0.0 area 0
R5(config-router)- network 192.168.2.0 0.0.0.255 area 0
R5(config-router)- network 192.168.3.0 0.0.0.255 area 0
On va ensuite vérifier que nos relations entre voisins sont bien
établies:
RX- show ip ospf neighbor
RX- show ip route
Exercice: Peut-on résumer certaines routes annoncées par R4 et R5?
(hint: /23). Testez
Configuration de l'Aire 1
Configurons maintenant nos routeurs de l'Aire 1. Tout d'abord, nous
allons configurer notre routeur R1 qui fait la jonction entre l'aire 0
et l'aire 1:
R1(config)- router ospf 1
R1(config-router)- network 172.18.0.1 0.0.0.0 area 1
Puis sur notre routeur R6:
R6(config)- router ospf 1
R6(config-router)- network 172.18.0.2 0.0.0.0 area 1
R6(config-router)- network 192.168.4.0 0.0.0.255 area 1
On vérifie comme précédemment que les infos de l'aire 1 sont bien
remontées sur R6 et R1.
Maintenant, vérifions - par exemple - sur R5 que les routes de l'aire 1
sont bien parvenues à l'aire 0:
R5- sh ip ospf neigh
R5- sh ip route
On va voir, si tout a bien fonctionné, que la route vers 192.168.4.0/24
est remontée avec le tag "IA", ce qui signifie /OSPF Inter Area/,
indiquant que la route apprise provient d'une autre zone OSPF.
Question: Est-ce que nous n'aurions pas oublié de configurer quelque
chose sur R1 et R6?
Configuration de l'Aire 2
Cette configuration va être très similaire à celle de l'aire 1:
Sur notre ABR R2:
R2(config)- router ospf 1
R2(config-router)- network 172.17.0.1 0.0.0.0 area 2
Puis sur R7:
R7(config)- router ospf 1
R7(config-router)- network 172.17.0.2 0.0.0.0 area 2
R7(config-router)- network 192.168.5.0 0.0.0.255 area 2
On procèdera aux mêmes vérifications que précédemment. Normalement, tout
devrait être fonctionnel.
Router IDs
Maintenant, comme on l'a vu précédemment, nos router-id ne sont pas
renseignées sur R6 et R7, ce qui signifie que nos deux routeurs
utilisent leur adresse IP la plus haute comme /Router-ID/. Ce n'est pas
problématique en soit, mais on peut vouloir "ranger" un peu tout ça .
Il suffit d'ajouter un router-id sur ces routeurs et de relancer le
processus ospf (ce qui va couper quelques secondes la connexion):
# par exemple sur R6:
R6(config)- router ospf 1
R6(config-router)- router-id 6.6.6.6
R6(config-router)- end
# au fait, vous avez bien enregistre les configs?
R6- wr mem
R6- sh ru
R6- clear ip ospf process
# valider
Redistribution des routes connectées
En fait, nous annonçons nos réseaux manuellement, c'est à dire que pour
chaque sous-réseau de nos routeurs, nous avons ajouté via la commande
/network/ chaque sous-réseau pour lesquels nous avions des routes
statiques.
On peut faire plus simple: on va utiliser la redistribution de routes
statiques d'OSPF. (/Note pour Quagga: on peut aussi redistribuer les
routes du noyau Linux ou BSD via la commande redistribute kernel, ce
qui peut être pratique dans le cas d'un setup d'un cluster
d'hyperviseurs où les machines virtuelles peuvent "bouger" entre les
membres du cluster (ex: KVM+DRBD)/)
Par exemple sur R6:
R6(config)- router ospf 1
R6(config-router)- redistribute connected subnets [metric 200 metric-type 2]
/metric-type 2/ indique ici que la métrique de 200 pour les sous-réseaux
annoncés par R6 sera redistribuée aux autres routeurs de notre setup
OSPF, qui ne modifieront donc pas cette valeur de métrique.
Configuration avancée
Influencer le choix du DR/BDR
Pour être "quasi" sûr que ce soit toujours le même routeur qui soit
désigné comme DR, on va modifier la priorité OSPF de l'interface qui est
reliée à la zone considérée. Admettons que l'interface Fa0/0 soit
connectée à l'aire où nous voulons que notre routeur soit toujours élu
DR:
Router(config)- interface Fa0/0
# ici XXX peut etre une valeur comme 100,200, etc
Router(config-if)- ip ospf priority XXX
À noter: une priorité de 0 empêchera le routeur de devenir DR ou BDR.
Question: comment pourrait on "forcer" l'élection du BDR?
Virtual Links: comment faire en sorte qu'une zone non-adjacente soit prise en compte
Il peut arriver, pour des questions de topologies notamment, qu'une zone
ne soit pas "adjacente", c'est à dire reliée directement, à l'aire 0. On
peut imaginer ce schéma:
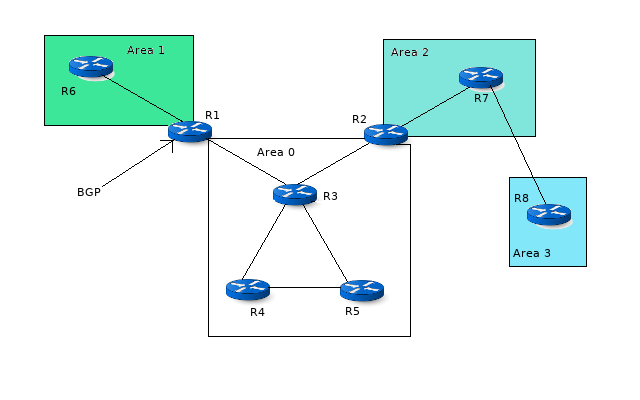
Ici, les informations de routage OSPF ne parviendront pas à l'aire 3.
On va alors mettre en place un /Virtual Link/ entre R8 et R2, via R7:
# sur R2:
R2(config)- router ospf 1
R2(config-router)- area 2 virtual-link 4.4.4.4
# sur R7:
R7(config)- router ospf 1
R7(config-router)- network W.X.Y.Z 0.0.0.0 area 2
R7(config-router)- network A.B.C.D 0.0.0.0 area 3
R7(config-router)- area 2 virtual-link 5.5.5.5
# OSPF est configure classiquement sur R8:
R8(config)- router ospf 1
R8(config-router)- network E.F.G.H 0.0.0.0 area 3
On va ensuite vérifier que R7 reçoit bien les routes via OSPF.
Question: à quelle aire R7 semble appartenir?
Zone de Stub, /Stubby Area/
Une zone de Stub, Stubby Area, est une zone où les messages LSA de type
4 et 5 ne circuleront pas. Au lieu d'obtenir la liste (ou un résumé) de
routes, les routeurs d'une zone de stub recevront une route par défaut
pointant sur l'ABR (sur l'interface connectée à la zone) entre la zone
considérée et l'aire 0.
Revenons à notre schéma de départ:
Admettons que nous voulons que l'aire 2 soit une aire de stub:
Sur R2:
R2(config)- router ospf 1
R2(config-router)- area 2 stub
Et sur R7:
R7(config)- router ospf 1
R7(config-router)- area 2 stub
Il ne reste plus qu'à vérifier que les routes externes ont bien été
remplacées par une route par défaut passant par 172.17.0.1 via un /show
ip route/
Totally Stubby Area
Le but d'une zone /Totally Stubby/ est d'empêcher le transit des LSA de
type 4 et 5, tout comme une Stubby Area, et aussi d'empêcher le
transit des LSA de type 3. Le routeur ne connaîtra que les routes
internes à sa zone, toutes les autres seront remplacées par une seule
route par défaut. Appliquons cela à notre aire 2:
Sur R2:
    R2(config)- router ospf 1
    R2(config-router)- area 2 stub no-summary
Et sur R7:
    R7(config)- router ospf 1
    R7(config-router)- area 2 stub
On verra que toutes les routes précédemment apprises par OSPF ont
disparu et sont remplacées par une route de type 0.0.0.0/0 via R2.
De même, si on utilise la commande /show ip ospf database/ on verra que
notre routeur R7 ne reçoit plus aucun LSA.
Résumé de routes
De même, si on regarde notre schéma, on voit que R4 et R5 routent
respectivement:
R4: 192.168.0.0/24 et 192.168.1.0/24
R5: 192.168.2.0/24 et 192.168.3.0/24
Et si on regarde la table de routage sur R6 par exemple, on voit qu'il
reçoit chaque route vers chaque sous réseau. Est-ce que, d'un point de
vue entrées dans la table de routage, il n'y aurait pas la possibilité
de "surnetter", ou résumer, les routes annoncées depuis la zone 0 vers
la zone 1 et la zone 2? En effet, les quatres sous-réseaux routés par R4
et R5 peuvent se résumer en un seul /22, 192.168.0.0/22. Ce serait donc
plus pratique d'annoncer 192.168.0.0/22 à nos autres zones, plutôt que
d'annoncer chaque sous-réseau, un par un, tant d'un point de vue entrées
dans la table de routage que temps de calcul du meilleur chemin par nos
routeurs (n'oublions pas que c'est un processus gourmand en CPU).
On va donc modifier notre configuration OSPF sur nos ABRs R1 et R2:
Sur R1 (R2 est évident aussi je ne le traite pas):
R1(config)- router ospf 1
R1(config-router)- area 0 range 192.168.0.0 255.255.252.0
R1 annoncera désormais à l'aire 1 une seule route pour nos quatre
sous-réseaux.
Spécificités d'OSPF en IPv6
Depuis OSPFv3 (2008), OSPF prend en charge IPv6. On va voir que les
différences de configuration sont minimes. Tout d'abord, il faut activer
IPv6 ET OSPF sur nos interfaces, ici dans le cas d'un ABR avec une zone
de stub:
Router(config)- ipv6 unicast-routing
Router(config)- interface Fa0/0
Router(config-if)- no ip address
Router(config-if)- ipv6 enable
Router(config-if)- ipv6 address 2003::1/124
Router(config-if)- ipv6 ospf 1 area 0
Router(config-if)- exit
Router(config)- interface Ge0/0
Router(config-if)- no ip address
Router(config-if)- ipv6 enable
Router(config-if)- ipv6 address 2002::1/44
Router(config-if)- ipv6 ospf 1 area 1
Router(config-if)- exit
Router(config)- ipv6 router ospf 1
Router(config-router)- router-id 1.1.1.1
Router(config-router)- area 1 stub no-summary
Router(config-router)- do wr mem
Question: l'aire 1 est de quel type?
Modification du calcul du coût de chaque lien
Pour terminer, on va voir comment modifier la façon dont est calculé le
coût de chaque lien par l'algorithme d'OSPF. En effet, OSPF est un
protocole qui a été développé à la fin des années 80 (RFC 1131), sa
version 2 datant de 1991 (mise à jour en 1998), et sa v3 avec prise en
charge d'IPv6 date de 2008 (RFC 5340).
Hors à l'époque de sa création, le top du top des vedettes des liens
réseau, c'était du FastEthernet 100Mbps - ce qui était à l'époque assez
faramineux. Le calcul du coût d'un lien s'effectue donc avec une valeur
maximum de la bande passante d'un lien de 100000kbps selon la "formule"
où $v_$ est la vitesse du lien et $v_$ la vitesse maximale
possible du réseau:
$$coût=\frac}}$$
arrondi à la valeur la plus faible, et à 1 si le résultat est inférieur
à 1, ce qui nous donne par exemple:
- Dans le cas d'un vieux lien série (tout pourri, il faut le dire) à
56kbps, une valeur de coût de 1785 - Dans le cas d'un vieux lien Ethernet 10Mbps, une valeur de 10
- Dans le cas d'un lien FastEthernet 100Mbps, une valeur de 1
- Dans le cas d'un lien Gigabit Ethernet, une valeur de... 1. /shrug/.
Il faut donc, sur nos routeurs, et si on dispose d'un lien Gigabit
Ethernet au moins, modifier la valeur $v_$ utilisée pour qu'OSPF
puisse calculer des coûts de liens en rapport avec la meilleure bande
passante du réseau. La valeur est renseignée en Mbps:
Router(config)- router ospf 1
Router(config-router)- auto-cost reference 1000
Question: (à la noix mais bon...) Si nous avions la chance d'avoir des
liens 10Gbps (miam), quelle serait la valeur de $v_$ ?
Authentification chiffrée OSPF
On ne veut pas utiliser d'authentification en /plaintext/ (nous sommes
en 2018!), aussi nous allons utiliser l'authentification... md5
(/shrug/). Bon, c'est mieux que rien... Pour mettre en place
l'authentification OSPF sur nos routeurs, il faut, sur chaque routeur:
Sur chaque interface de nos routeurs participant à la discussion OSPF,
nous allons mettre en place notre clef de chiffrement "md5" (/sigh/)
Puis dans la configuration de notre routeur OSPF, nous allons lui
indiquer de l'utiliser pour chaque aire (on peut donc mettre en place
des mots de passe différents pour chaque aire)
Par exemple, dans le cas de R6, aire 1, dont l'interface Fa0/0 est
connectée à R1 (notre ASBR):
R6(config)- int fa0/0
R6(config-if)- ip ospf message-digest-key 1 md5 BGPRuleZ
R6(config-if)- exit
R6(config)- router ospf 1
R6(config-router)- area 1 authentication message-digest
Et ainsi de suite
EIGRP
Principe de fonctionnement
Présentation
/Enhanced Interior Gateway Routing Protocol/ était un protocole
propriétaire Cisco, il a été libéré en 2013. C'est un IGP, tout comme
OSPF. EIGRP utilise son propre protocole de session, sur la même couche
OSI que TCP (i.e. la couche 4): /Reliable Transport Protocol/, RTP, à ne
pas confondre avec le protocole RTP utilisé en VoIP . EIGRP est un
protocole à /à vecteur de distance/ hybride, mais qui, par le
fonctionnement de ses mises à jour de routage, profite aussi de certains
avantages des protocoles à état de lien comme OSPF.
EIGRP prend en charge le VLSM, tout comme OSPF, et, tout comme OSPF,
utilise /multicast/ pour communiquer entre voisins, sur l'adresse
224.0.0.10. Un des avantages d'EIGRP est sa faculté à effectuer du
Load-Balancing (jusqu'à 6 liens) - il est aussi capable de répartir la
charge sur des liens dont le coût (la métrique) est différent. Il est
aussi capable de calculer une route de secours en cas de problème, c'est
à dire qu'il conserve en mémoire deux routes pour une destination
donnée: la route principale (celle qui dispose de la meilleure
métrique), et une route secondaire - on verra plus loin comment EIGRP
détermine cette route secondaire.
Terminologie
Tout comme OSPF dispose de sa propre terminologie (Drothers, DR, BDR,
etc), plusieurs termes sont spécifiques à EIGRP, de par son mode de
fonctionnement et ses capacités (notamment de répartition de charge):
- Feasible Distance :: (/aka/ FD) Il s'agit de la distance totale pour
joindre une destination. Elle est calculée en additionnant les coûts de
chaque lien traversé pour atteindre cette destination. - Advertised Distance :: aussi appelée Reported Distance, AD, c'est la
distance annoncée par un voisin pour joindre un réseau qu'il connaît
(c'est à dire la FD qu'il a avec ce réseau). - Successor :: il s'agit du voisin choisi pour joindre une destination
- Feasible Successor :: C'est le voisin choisi pour joindre une
destination si le Successor est "tombé". Pour devenir FS, il faut une AD
plus faible que la FD du Successor (atchoum! - vous suivez?)
Calcul de la métrique par EIGRP
EIGRP calcule les coûts sur la base de quatre paramètres influencés par
5 coefficients "K":
- Le Délai, qui est défini par la somme des délais de la route considérée
en dizaines de microsecondes. Ce délai est fixé de façon arbitraire à
20000 microsecondes pour un lien série, et 1000 microsecondes pour un
lien Ethernet. - La Bande Passante (BP) est définie comme $10^$ kbps divisé par la
bande passante la plus faible du chemin de la route considérée - La Fiabilité est un entier de 0 à 255, déterminée en fonction de la
performance du lien - Et enfin la Charge, déterminée de la même façon que la Fiabilité
Les constantes K1 à K5 peuvent être modifiées par l'administrateur pour
obtenir des comportements différents du protocole suivant les besoins.
Par défaut:
La formule pour calculer la métrique /m/ d'un lien est donc:
$$m = 256.(K1.BP + \frac + K3.Délai).\frac$$
En règle générale, par défaut:
- K1 et K3 sont égaux à 1.
- K2, K4 et K5 sont égaux à zéro (lorsque K5=0, le rapport K5/K4
ci-dessous est considéré comme valant 1).
Et donc notre formule devient:
$$m = 256.(\frac + \sum\frac)$$
La métrique d'un lien Ethernet à 1Mbps, 1024 kbps, suivi par un lien
Ethernet à 10Mbps sera donc:
$$m = 256.(\frac + \frac) = 256.(9765 + 200) = 2551040$$
De même, la /Distance Administrative/ Cisco pour EIGRP est de 90 en
interne et 170 en externe.
Comment EIGRP communique
EIGRP utilise 5 types de messages pour communiquer:
- Hello :: Tiens, le revoilà! Il est envoyé aux voisins toutes les 5
secondes. Si un voisin ne répond pas après 3 Hellos, il est considéré
comme DOWN. - Update :: Ce message est envoyé uniquement en cas de changement dans la
topologie du réseau, afin de mettre à jour la table de routage des
routeurs concernés - Query :: Ce message est envoyé (en multicast et en unicast) par un
routeur qui cherche une route vers un réseau. Si le routeur qui reçoit
cette Query ne connaît pas la route demandée, il retransmet alors cette
/Query/ à ses voisins, et ainsi de suite. Afin d'éviter de rester
bloqué, un routeur "attendra" 180 secondes de recevoir une réponse. S'il
reçoit une réponse à sa requête, il mettra à jour sa table de routage en
fonction du message suivant (sinon, il abandonne): - Reply :: Si un routeur qui a reçu une /Query/ connaît la réponse, il
enverra un message Reply (en unicast), qui indique que ce routeur
connaît la destination demandée, ainsi que la métrique de cette
destination. Dans le cas contraire, la réponse contient une métrique
"infinie". - Ack :: Le grand classique, c'est un accusé de réception pour les
messages /Query, Update et Reply/. Un message /Hello/ ne renvoit pas
d'Ack (il renvoie un autre /Hello/).
Les tables d'EIGRP
Tout comme la DBD d'OSPF, EIGRP stocke les données relatives à ses
voisins, à la topologie du réseau, etc, dans trois tables spécifiques:
- Neighbor Table :: elle contient la liste de tous les voisins du routeur.
Elle est accessible via la commande, Ô combien originale, /show ip eigrp
neigh/ - Topology Table :: Elle contient la liste des destinations joignables,
avec le Successor associé et le FS s'il y en a un. Comme EIGRP ne
connaît pas la topologie du réseau, contrairement à OSPF, c'est un terme
un peu "abusif". On peut la voir avec la commande /sh ip eigrp
topology/
/Note: Il est tout à fait possible d'avoir deux Successors pour une même route, si ces deux routes ont la même FD: EIGRP répartira la charge entre les deux Successors. Not bad /
- Routing Table :: elle se passe de commentaire
Avantages
EIGRP n'envoie ses mises à jour que lorsqu'un changement intervient.
Aucune mise à jour n'est envoyée si la topologie du réseau n'est pas
modifiée. De même, une mise à jour ne contient que ce qui a été modifié
(on ne renvoie pas la totalité de la table de routage, etc).
- De par son fonctionnement, il est peu gourmand en ressources
- Il est multi-protocoles: il peut router IP, mais aussi IPX ou Apple
Talk. - Il est capable d'effectuer de la répartition de charge
- Il est capable de calculer une route de secours
Après un peu de config', il est aussi capable de faire de la répartition
de charge asymétrique, c'est à dire répartir la charge entre un lien
"rapide" et un lien "plus lent".
Configuration
Considérons d'abord la configuration suivante (pas de dessin moche ce
coup-ci mais un screenshot de PacketTracer - je n'ai pas pu tester EIGRP
sur mon lab perso (containers LXC, Debian, Quagga), donc... j'ai
installé PacketTracer dans un container sur ma machine perso.):
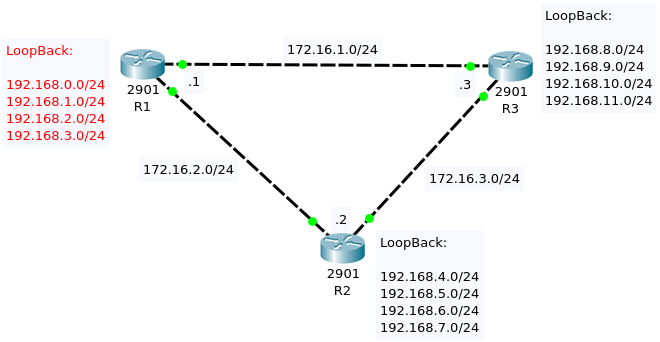
Ici, on veut annoncer les routes que chaque routeur connaît via EIGRP.
Comme vous allez voir, la configuration est tout aussi simple que pour
OSPF. On va par contre désactiver le résumé automatique des routes: on
peut avoir des surprises avec.
Mise en place d'EIGRP
Sur chaque routeur de notre réseau, nous allons activer EIGRP. Par
exemple sur R1:
# ici, il faut preciser le numero d'AS! On part du principe qu'on utilise l'AS 100
R1(config)- router eigrp 100
R1(config-router)- no auto-summary
# On indique le wildcard, pas le masque!
R1(config-router)- network 172.16.1.0 0.0.0.255
R1(config-router)- network 172.16.2.0 0.0.0.255
# puis nos interfaces de LoopBack:
R1(config-router)- network 192.168.0.0 0.0.3.255
Et ainsi de suite pour nos deux autres routeurs.
On vérifie que nos routeurs discutent bien:
R1(config-router)- do sh ip eigrp neigh
R1(config-router)- do sh ip eigrp topology
R1(config-router)- do sh ip route
Par contre, nos routes ne sont pas résumées... c'est un peu moche, non?
Et surtout, peu lisible: imaginez des centaines de routes dans votre
table de routage... On va donc procéder au résumé de nos routes:
Résumé des routes
Contrairement à OSPF, on ne résume pas nos routes en mode de
configuration du routeur (router eigrp ASN), mais on résumera nos
routes au niveau des interfaces. Si R1 dispose de deux interfaces
GigabitEthernet g0/0 et g1/0, on annoncera donc le résumé de nos routes
de la manière suivante:
R1(config)- interface g0/0
R1(config-if)- ip summary-address eigrp 100 192.168.0.0 255.255.252.0
# on procede de meme pour g1/0 et sur nos autres routeurs.
Ici, on passe en paramètres de /ip summary-address eigrp/ l'ASN, l'IP du
réseau à résumer, et enfin le masque de sous-réseau (et non pas le
wildcard).
Interfaces Passives
Il peut être - et c'est d'ailleurs fortement conseillé - utile
(notamment d'un point de vue sécurité) de mettre en place des /Passives
Interfaces/ sur nos routeurs. Une interface "passive":
- N'envoie pas les mises à jour de routage
- N'envoie pas de Hello
- Ignore les messages Hello et les mises à jour de routage entrantes
Enfin, si une le sous-réseau d'une interface passive est inclus dans la
commande /network/, le réseau auquel elle appartient est lui, toujours
annoncé.
la syntaxe de la commande est (par ex ici sur R1, pour l'interface
/lo0/):
R1(config)- router eigrp 100
R1(config-router)- passive-interface loopback 0
Une manière plus efficace serait de n'activer que les interfaces sur
lesquelles nous voulons qu'EIGRP discute:
R1(config)- router eigrp 100
R1(config-router)- passive-interface default
R1(config-router)- no passive-interface ge0/0
R1(config-router)- no passive-interface GigabitEthernet 1/0
Attention, lorsqu'on va passer la première commande, toutes les
relations de voisinage vont être coupées. À éviter en production
Répartition de charge asymétrique
Si EIGRP permet de faire de la répartition de charge (/Load Balancing/)
naturellement si deux FD sont identiques, c'est à dire que nous avons
deux Successors désignés, on peut aussi vouloir faire de la répartition
de charge entre des liens dont les métriques ne sont pas identiques. Par
exemple, imaginons que nous ayons un lien Gigabit, et un lien
FastEthernet, annonçant la même route.
Si la bande passante n'est pas une composante essentielle de
l'infrastructure, on va pouvoir dire à EIGRP d'utiliser les deux liens.
Il faut pour cela lui dire d'utiliser des liens /X/ fois /pires/ que le
lien avec le Successor actuel. Dans le cas d'une répartition de charge
entre Gigabit et Fast Ethernet, on peut imaginer que FastEthernet est
/10 fois pire/ que GigabitEthernet. On va donc modifier la /variance/ de
notre setup EIGRP:
Router(config)- router eigrp 100
# le parametre variance va de 1 a 128
Router(config-router)- variance 10
# ici, on indique a notre routeur de n'envoyer qu'un paquet sur 10 a notre lien FastEthernet:
Router(config-router)- traffic-share balanced
Pour que /Unequal Cost Load Balancing/ soit activé, il ne reste plus
qu'à recréer nos relations de voisinage avec la commande:
Router- clear ip eigrp 100 neighbors
Authentification EIGRP
Ici, on veut empêcher un routeur non-autorisé de participer à la
discussion EIGRP. On va donc mettre en place l'authentification sur nos
interfaces réseau discutant en EIGRP. On commence tout d'abord par
créer nos clefs, dans un trousseau dédié.
On créera deux clefs, avec des priorités différentes, la seconde clef
étant valable "à l'infini", et sera donc utilisée pour chiffrer nos
messages EIGRP lorsque la première aura expiré (il faudra alors en
générer une nouvelle), ceci dans le but de ne pas "enfermer dehors" nos
autres routeurs en cas d'indisponibilité d'un administrateur à
l'expiration de la première clef.
ATTENTION: la durée de vie, l'ID et la chaîne de caractère utilisée
pour chiffrer nos communications EIGRP doivent être identiques sur
chaque routeur.
Par exemple, sur R1 (retour à notre schéma précédent du début):
R1(config)- key chain MY_LITTLE_EIGRP
# ici, on renseigne l'ID de notre clef:
R1(config-keychain)- key 1
R1(config-keychain-key)- key-string OSPFvaincra
R1(config-keychain-key)- accept-lifetime 00:00:00 1 jan 2018 00:00:00 1 jan 2019
R1(config-keychain-key)- send-lifetime 00:00:00 1 jan 2018 00:00:00 1 jan 2019
R1(config-keychain-key)- exit
R1(config-keychain)- key 2
R1(config-keychain-key)- key-string EIGRPcestbienquandmeme
R1(config-keychain-key)- accept-lifetime 00:00:00 31 dec 2018 infinite
R1(config-keychain-key)- send-lifetime 00:00:00 31 dec 2018 infinite
R1(config-keychain-key)- do wr mem
On procède de même sur nos autres routeurs. On active ensuite le
chiffrement des échanges EIGRP sur toutes nos interfaces réseau
participant à la communauté EIGRP de tous nos routeurs. Ici je prends
comme exemple R1:
R1(config)- interface g0/0
R1(config-if)- ip authentication mode eigrp 100 md5
R1(config-if)- ip authentication key-chain eigrp 100 MY_LITTLE_EIGRP
# idem sur g1/0
On effectue la même manipulation sur nos autres routeurs.
ATTENTION: toutes les communications seront coupées!! Donc, faire
attention dans un environnement de production!
EIGRP et IPv6
La configuration d'EIGRP et IPv6 est très simple. Il va falloir:
- Activer IPv6 sur nos interfaces
- Activer eigrp pour ipv6 sur nos interfaces
- Configurer notre routeur pour utiliser le mode ipv6 d'EIGRP.
Typiquement, si notre ASN est 100, ça va nous donner une configuration
de ce type:
Router(config)- int fa0/0
Router(config-if)- no ip address
Router(config-if)- ipv6 address XXXX:YYYY::/MASK
Router(config-if)- ipv6 enable
Router(config-if)- ipv6 eigrp 100
Router(config-if)- ex
Router(config)- ipv6 router eigrp 100
Router(config-router)- eigrp router-id A.B.C.D
Router(config-router)- no shutdown
Et... c'est à peu près tout
MPLS
/MPLS/, Multi Protocol Label Switching (RFC 3031), est un protocole de
transport de données "à cheval" sur les couches 2 et 3 du Modèle OSI
(c'est à dire entre la couche liaison et la couche réseau). En effet,
MPLS insère et retire respectivement en entrée et en sortie des
/labels/, étiquettes, aux données qu'il fait transiter. En effet, MPLS
ne se limite pas à IP (v4, v6), mais est aussi capable de relayer tout
type de trafic, y compris des trames Ethernet, ATM, de la voix, etc.
MPLS a été développé à partir de 1996, suite à une proposition de
Toshiba datant de 1994. Au début, il n'était sensé fonctionner que sur
des réseaux ATM. Cisco proposa ensuite de ne pas limiter MPLS à ATM
(/Asynchronous Transfer Mode/, protocole de niveau 2 qui a été développé
à l'origine pour remplacer le RTC), et ajouta le /Tag Switching/,
renommé par l'IETF /Label Switching/ lors de la standardisation du
protocole MPLS. En 1997, le groupe de travail de l'IETF sur MPLS est
formé, les premiers déploiements de MPLS arrivant en 1999. En 2000, la
QoS est ajoutée. Les premières RFC concernant MPLS datent de 2001. Le
support de Multicast est ajouté en 2009. Le travail sur ce protocole
continue depuis.
/Note: l'IETF, Internet Engineering Task Force, produit les standards utilisés sur Internet. L'IETF est aussi en charge de la rédaction des fameuses RFC (Request For Comments). Si toutes les RFC ne sont pas des standards tous les standards sur Internet sont des RFC./
Concepts
Principe de fonctionnement
MPLS utilise la commutation d'étiquettes pour fonctionner. Les chemins
MPLS sont toujours unidirectionnels. Ils peuvent être établis
manuellement, ou automatiquement via /Label Distribution Protocol/ (LDP)
ou d'autres protocoles (OSPF-TE). Comme nos chemins MPLS sont
unidirectionnels, il faut différencier les routeurs d'entrée (iLSR,
/Ingress Label Switch Router/), de transit (/P-router/), et enfin de
sortie (/Egress Label Switch Router/).
Un ensemble de routeurs formant un réseau MPLS est appelé un /domaine
MPLS/.
un iLSR va encapsuler le trafic reçu de l'extérieur (i.e depuis un
/Label Edge Router/, LER) en générant au moins un label (20bits). Pour
créer ce label, le routeur utilise une ou plusieurs informations du
paquet (ou de la trame, ou de la session, etc):
- Adresse MAC de l'émetteur
- Adresse IP de l'émetteur
- Port TCP ou UDP
On appelle ces informations des /Forwarding Equivalence Class/, FEC. Une
FEC détermine vers quelle interface, et avec quels critères de
transmission (label), les informations reçues seront transmises.
L'ensemble des données insérées par notre LSR est nommé /label stack/.
Cette pile contient:
- Le label lui-même, de taille 20 bits. Un label avec une valeur de 1 est
un label d'alerte de routeur, qui va demander au LSR le recevant de
réexaminer le contenu du paquet. - 3 bits réservés à la classe de trafic (/Traffic Class/) pour effectuer
de la QoS - 1 bit /Bottom of Stack/: si ce bit est à 1, alors le label en question
est le dernier de la pile - 8 bits de TTL (classique).
On voit donc que l'ensemble des informations ajoutées par notre iLSR
"tient" sur 32 bits.
/À noter: un LSR peut ajouter plusieurs labels à un paquet de données,
en fonction des besoins/
l'iLSR transmet ensuite les données à un P-router, qui comporte une
table de communication avec quatre entrées:
- l'interface d'entrée du paquet
- le label MPLS en entrée
- l'interface de sortie du paquet
- le label MPLS de sortie
Le P-router va utiliser ces informations pour transmettre les
informations à un autre P-router ou à un eLSR. Il ne va pas parcourir sa
table de routage pour déterminer où envoyer le paquet, ce qui fait de
MPLS un protocole très rapide (du moins à l'époque de sa création, les
routeurs étant maintenant bien plus performants). En fin de chaîne,
l'eLSR "décapsule" les informations et les transmet à la destination,
c'est à dire à un LER.
Il est nécessaire de configurer le(s) chemin(s) (qu'on appelle LSP
/Label Switched Path/) que va(vont) emprunter nos informations. On peut
le faire:
- De façon manuelle, pour les grands malades - cette opération peut être
extrêmement fastidieuse, notamment sur de grands réseaux. - En utilisant un protocole de signalisation afin d'obtenir nos LSPs: soit
via le standard IETF LDP, soit en utilisant un protocole préexistant
comme BGP, OSPF et son extension OSPF-TE, etc.
Il faut aussi garder en mémoire que MPLS n'est pas un protocole de
bout-en-bout comme IP. Il se contente d'encapsuler des protocoles de
couche 2 et 3. MPLS lui même peut être transporté par un protocole de
couche 1, 2 ou 3. En gros, on peut très bien encapsuler de l'Ethernet en
MPLS qui lui même sera transporté en Ethernet. Ou encapsuler de l'ATM en
MPLS qui sera transporté par du X.25. Je vous ai parlé des VPNs et de
MPLS?
Plus sérieusement, en pratique, on utilise principalement MPLS en
production pour transporter:
- Des paquets IP
- Des trames Ethernet
De plus, en règle générale, par exemple sur un /traceroute/, les
utilisateurs finaux ne verront que les routeurs d'entrée et de sortie,
et pas le réseau interne à notre AS. Ce qui peut être... pas mal pour
éviter que des petits malins testent la topologie du réseau interne à
notre AS.
Vous vous rappelez des /Label Edge Routers/, LER?
On va maintenant attaquer le gros morceau:
LER, PHP (Penultimate Hop Popping) et VRF (Virtual Routing and
Forwarding)
En règle générale, un LER est un routeur:
- Qui est présent à la bordure de notre réseau MPLS
- Qui n'est pas, en général (car sinon bonjour les perfs sur un grand
réseau!), le /PHP/, c'est à dire le routeur eLSR qui va décapsuler nos
informations MPLS, i.e. enlever le label "externe" utilisé par les iLSR,
P-routers et eLSR. - Par contre, c'est le routeur qui va "décapsuler" le label "interne", qui
identifie quelle instance de /Virtual Routing and Forwarding/, VRF,
utiliser pour transmettre le paquet à la destination.
Pour simplifier, en MPLS:
- Un de nos LER reçoit un paquet sur une de ses VRF. Il /tagge/ alors ce
paquet, puis le transmet à un iLSR - l'iLSR rajoute un (ou plusieurs) nouveau label, et envoie les données à
un P-router - Notre paquet suit son chemin dans notre domaine MPLS, en fonction de son
LSP. - il atteint un eLSR, qui enlève le label "externe" (celui ajouté par
l'iLSR en entrée), et transmet le paquet à un LER. Notre eLSR est aussi
notre PHP dans ce cas. - Le LER de sortie détermine, en fonction du label "interne" (celui ajouté
par notre LER d'entrée), quelle VRF utiliser pour transmettre le paquet
à la destination.
Mise en place et configuration
Bon, commençons par la mauvaise nouvelle: PacketTracer ne supporte pas
MPLS, il n'est donc pas possible de simuler un domaine MPLS. On va
partir sur un setup simple, qui va aussi permettre de voir l'intérêt de
MPLS:
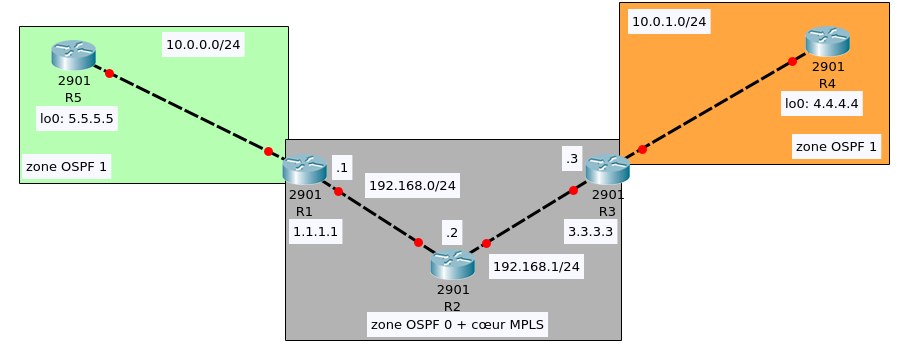
Ici, on a donc deux zones OSPF:
- Notre aire 0, qui est aussi notre cœur MPLS. (j'ai oublié sur le schéma,
mais R2 a une adresse de loopback en 2.2.2.2, R5 et R4 ont l'adresse .2
de leurs sous-réseaux respectif, et R1 et R3 l'adresse .1) - L'aire 1, qui est /dispatchée/ sur deux sites différents.
On va aussi partir de quelques principes:
- Les liens de R1 et R3 dans l'aire 0 sont sur les interfaces fa0/0 (ou
ge0/0, etc) - Les liens de R1 et R3 dans l'aire 1 sont sur les interfaces fa0/1 (ou
ge0/1, etc)
Mise en place de l'adressage et d'OSPF dans notre aire 0
Ici, on ne devrait pas rencontrer trop de problème, ça coule de source
maintenant
Sur R1:
R1(config)- int lo0
R1(config-if)- ip addr 1.1.1.1 255.255.255.255
R1(config-if)- ip ospf 1 area 0
R1(config-if)- ex
R1(config)- int f0/0
R1(config-if)- no shu
R1(config-if)- ip addr 192.168.0.1 255.255.255.0
R1(config-if)- ip ospf 1 area 0
R1(config-if)- do wr mem
On procède de même pour R2 et R3.
On vérifie ensuite que nos infos et notre table de routage sont OK et
que tout le monde trouve bien ses voisins. On va passer à la mise en
place de MPLS dans notre mini-réseau:
Mise en place de MPLS et LDP
Il va falloir:
Sur chaque routeur de notre cœur MPLS, et sur chaque interfaces
internes à notre zone 0 de nos routeurs, activer mpls via la commande
/mpls ip/
Dans notre configuration OSPF, activer la configuration automatique de
MPLS via la commande /mpls ldp autoconfig/
Par exemple sur R1:
R1(config)- int lo0
R1(config-if)- mpls ip
R1(config-if)- ex
R1(config)- int f0/0
R1(config-if)- mpls ip
R1(config-if)- ex
R1(config)- router ospf 1 area 0
R1(config-router)- mpls ldp autoconfig
Sur R2, il faudra donc configurer f0/0 et f0/1.
On vérifie que tout le monde peut se parler:
R1- sh mpls interface
R1- sh mpls ldp neigh
R1- ping 2.2.2.2
R1- trace 3.3.3.3
# on devrait voir la route prise par notre paquet,
# avec les infos MPLS correspondantes.
etc
Là, on devrait donc avoir:
- Configuré nos adresses IP
- Mis en place OSPF dans notre zone 0
- configuré MPLS et LDP dans notre mini-cœur de réseau.
Pour continuer dans la mise en place de nos VRF, on va maintenant
établir un lien BGP entre R1 et R3:
Mise en place d'un lien iBGP entre R1 et R3
Sur R1:
R1(config)- router bgp 100
R1(config-router)- neighbor 3.3.3.3 remote-as 100
R1(config-router)- neighbor 3.3.3.3 update-source Loopback0
R1(config-router)- no auto-summary
R1(config-router)- address-family vpnv4
R1(config-router)- neighbor 3.3.3.3 activate
Sur R3:
    R3(config)- router bgp 100
    R3(config-router)- neighbor 1.1.1.1 remote-as 100
    R3(config-router)- neighbor 1.1.1.1 update-source Loopback0
    R3(config-router)- no auto-summary
    R3(config-router)- address-family vpnv4
    R3(config-router)- neighbor 1.1.1.1 activate
On vérifie (c'est l'occasion de voir quelques commandes BGP
supplémentaires) que tout est OK:
R1- sh ip bgp vpnv4 unicast all summary
C'est ici que nous allons ajouter nos routeurs R4 et R5, et créer -
enfin - nos VRF:
Ajout de nos routeurs "voisins" et création de nos VRF
sur R5:
R5(config)- int lo0
R5(config-if)- ip addr 5.5.5.5 255.255.255.255
R5(config-if)- ip ospf 1 area 1
R5(config-if)- ex
R5(config)- int fa0/0
R5(config-if)- ip addr 10.0.0.2 255.255.255.0
R5(config-if)- no shu
R5(config-if)- ip ospf 1 area 1
Sur R1:
R1(config)- int f0/1
R1(config-if)- no shu
R1(config-if)- ip addr 10.0.0.1 255.255.255.0
Maintenant, on va voir que R1 et R5 sont bien /peers/, mais on ne veut
pas que R5 apparaisse dans la table de routage globale de R1. C'est là
que nous allons mettre en place notre VRF. Par convention, on utilise
souvent des noms de couleurs pour identifier nos VRF, on va choisir BLUE
(mais on peut mettre RED, YELLOW, GREEN, MAGENTA, etc). VRF nous permet
d'avoir plusieurs instances d'une table de routage coexistant mais
n'interférant pas l'une avec l'autre sur un routeur.
Attention, ça pique, et on va aussi voir les notions de /Route
Distinguisher/ et de /Route Target/
R1(config)- ip vrf BLUE
R1(config-vrf)- rd 100:1
R1(config-vrf)- route-target both 100:1
Ouhlà, qu'est-ce qu'on vient de faire?
Eh bien, un /Route Distinguisher/ (RFC 4364) a un seul but: être sûr que
les préfixes IPv4 sont globalement uniques. C'est utilisé par un LER
pour identifier à quel VPN un paquet appartient, pour être sûr que si
nous avons deux sous-réseaux 172.16.0.0/24 reliés à notre LER via ses
VRF, notre LER saura à qui renvoyer le paquet de retour. Une pratique
courante est de le numéroter de la sorte: ASN:Site-ID ou client-id, etc.
Ici, vous pouvez voir que je l'ai nommé 100:1, c'est à dire AS100,
client numéro 1.
/Route Target/, quant à elle, est un attribut BGP étendu (RFC 4360), qui
défini quels préfixes sont exportés et importés dans nos LER. la
commande /route-target/ peut prendre plusieurs arguments:
import: définit les préfixes importés depuis l'extérieur. Par exemple,
si nous avons un routeur R6 connecté, disons d'un second client, et
qu'il adresse le même sous-réseau que R5, on pourra importer les routes
de R5 dans notre VRF BLUE via route-target import 100:1 et les routes de
R6 dans une VRF YELLOW via route-target import 100:2
export: idem mais en export
both: permet de configurer import et export simultanément.
notez qu'on aurait très bien pu configurer notre route-target
complètement différemment de notre RD, par exemple /route-target both
4:4/ dans notre VRF BLUE et /route-target both 12:34/ dans notre VRF
YELLOW de notre second client. Même si en général, on utilise
ASN:Site-ID aussi bien dans notre RD que pour nos route-target, il faut
garder à l'esprit qu'il s'agit de deux choses différentes.
Pour résumer:
- Le /Route Distinguisher/ crée une adresse VPNV4 unique à travers le
réseau MPLS - La /Route Target/ définit quels préfixes sont importés et exportés sur
le routeur LER (qu'on peut aussi appeler Provider Edge, PE)
On va maintenant appliquer notre VRF à notre interface réseau nous
connectant à R5:
R1(config)- int f0/1
R1(config-if)- ip vrf forwarding BLUE
# et la, le drame, notre adresse IP est effacee de l'interface.
# c'est normal, on va donc la remette en place:
R1(config-if)- ip addr 10.0.0.1 255.255.255.0
R1(config-if)- no shu
Maintenant, sur un /sh ip route/, la route vers R5 n'apparaît plus dans
la table de routage globale. Par contre, sur un /sh ip rou vrf BLUE/, on
verra bien apparaître notre route.
Il ne reste plus qu'à mettre en place OSPF sur l'interface f0/1 de R1:
R1(config)- int f0/1
R1(config-if)- ip ospf 1 area 1
Il ne nous reste plus qu'à mettre en place notre VRF sur R3, et
configurer R4, de la même manière.
Maintenant, nous allons devoir redistribuer les routes OSPF entre les
deux sites via MP-BGP. Pour cela, on va devoir:
- Redistribuer les routes OSPF de R5 dans MP-BGP sur la VRF de R1
- Redistribuer les routes OSPF de R4 dans MP-BGP sur la VRF de R3
Et enfin redistribuer sur OSPF les routes apprises par R1 et R3, vers
nos deux sites. Pfiou!
Redistribution d'OSPF dans MP-BGP
Sur R1:
R1(config)- router bgp 100
R1(config-router)- address-family ipv4 vrf BLUE
R1(config-router)- redistribute ospf 1
Sur R3:
R3(config)- router bgp 100
R3(config-router)- address-family ipv4 vrf BLUE
R3(config-router)- redistribute ospf 1
Maintenant, si on vérifie sur R1 et R3 quelles routes sont annoncées par
MP-BGP:
R1- sh ip bgp vpnv4 vrf BLUE
On devrait voir remonter les informations de R5 et R4 sur chaque
routeur.
R1 et R3 connaissent donc leurs routes réciproques. Par contre, R4 et R5
ne connaissent pas les routes vers leurs sites distants respectifs.
Oups... il nous reste donc à redistribuer les routes apprises par MP-BGP
dans l'aire 1 OSPF de nos deux sites, on va y arriver!
Redistribution de MP-BGP dans OSPF
Sur R1:
R1(config)- router ospf 1
R1(config-router)- redistribute bgp 100 subnets
Et on procède de la même manière sur R3.
On devrait donc pouvoir /pinger/ R4 depuis R5 et vice-versa!
De même, jetons un œil à la table de routage de R5, puis effectuons un
traceroute vers 4.4.4.4, l'IP de /loopback/ de R4:
R5- ping 4.4.4.4
R5- trace 4.4.4.4
TP: ajouter un second "client", avec les mêmes sous réseaux pour R6 et
R7, une nouvelle VRF, etc
Gestion de la QoS
Définition
La Qualité de Service (QoS) a pour but d'assurer le bon fonctionnement
de l'infrastructure et ce même dans un environnement extrêmement chargé,
en optimisant l'utilisation des ressources pour fournir les meilleures
conditions de transport à un trafic réseau donné, en agissant sur (et en
fonction de/du) le débit, les délais de transmission, la variance/gigue,
les taux de pertes de paquets, etc.
Bien évidemment, la qualité /perçue/ du service va dépendre des
/besoins/ de ce service. Par exemple, de la VOD ou du téléchargement
préfèreront avoir une bande passante élevée à une latence faible.
Inversement, un jeu vidéo type FPS sera plus agréable à jouer avec une
latence faible (et moins rageant :p). De même, la VoIP s'accomode mal
d'une gigue (/jitter/) importante. Il faut donc différencier le type de
trafic réseau afin de lui appliquer les règles les plus efficaces pour
sa transmission à sa destination.
On utilise généralement plusieurs critères pour déterminer le type de
QoS à utiliser:
- La source et la destination du paquet
- Le protocole utilisé: UDP, TCP, ICMP, IGMP, etc
- Les ports source et destination pour les protocoles TCP et UDP
- La date et l'heure
- La congestion du/des réseaux
- L'état des routes, leur métrique
- La bande passante utilisée
- La latence
La QoS s'effectue sur la couche 3 (et un chouilla sur la couche 4
(ports)) du modèle OSI. Une QoS s'effectuant au delà de ces couches (par
exemple en analysant le contenu de la couche applicative, DPI, /Deep
Packet Inspection/) violerait les principes de la neutralité du réseau.
De même, une limitation artificielle du débit sur son réseau en fonction
de son origine (par exemple, s'il s'agit d'un concurrent), constituerait
une violation de ces mêmes principes. (cf Free et Youtube il y a
quelques années).
On peut appliquer plusieurs stratégies pour améliorer la qualité de
service:
- Choix des routes :: a-t-on besoin d'une latence faible mais d'un débit peu
important, ou à l'inverse d'un débit important quel que soit la latence,
et quelle route remplit la condition voulue? - Traffic Shaping :: pour limiter le trafic, soit en délayant des paquets,
soit en limitant la bande passante pour un type donné de trafic
(bittorrent...), ou à l'inverse de toujours assurer un débit minimum à
un type de trafic donné (Netflix anyone?). On utilise en général les
algorithmes du seau percé (en contrôlant le nombre de pps passant par un
routeur, tout en ne dépassant pas une limite fixée (le "volume du
seau")) et l'algorithme du seau à jeton (/token bucket/): ici, on
détermine le trafic en fonction de la taille des paquets et d'un
compteur représentant la limite de quantité de mémoire disponible pour
stocker les paquets avant de les envoyer. - L'ordonnancement de nos files d'attentes :: En général on applique
l'algorithme FIFO (/First In, First Out/) par défaut sur les interfaces
avec un débit supérieur à 2Mbps. On peut, à l'inverse, "prioriser" un
type de trafic (les paquets non-prioritaires ne passeront que lorsqu'il
n'y a plus de trafic prioritaire), c'est le /priority queuing/), ou
utiliser le /fair queuing/, qui consiste à s'assurer qu'aucune
application ne peut écraser les autres.
Matériel prenant en charge la QoS
Source:
https://www.cisco.com/c/fr_ca/support/docs/quality-of-service-qos/qos-policing/22833-qos-faq.html
NBAR signifie /Network Based Application Recognition/.
Mise en place de la QoS sur MPLS
On travaillera sur les interfaces sur lesquelles nous voulons appliquer
de la QoS. Plusieurs mécanismes sont disponibles sur les différents
modèles Cisco (tous ne disposent pas de tous les mécanismes de QoS par
contre):
/Weighted Random Early Detection/ (WRED) et sa variante /Distributed
WRED/ pour éviter la congestion.
Ici, on se place sur l'interface voulue, puis:
# On active CEF:
Router(config)- ip cef (ou ip cef distributed sur un 7500)
Router(config)- interface type numero
# On active WRED
Router(config-if)- random-detect
# On peut configurer finement WRED, mais ce n'est pas recommande par Cisco
Router(config-if)- random-detect precedence precedence_value min-threshold max-treshold mark-probability
# exemple:
Router(config-if)- random-detect precedence 0 100 218 10
Router(config-if)- random-detect precedence 1 100 218 10
# Verification des parametres:
Router(config-if)- do sh queueing random-detect
/Committed Access Rate/, CAR, et sa variante DCAR, qui classifie les
paquets (souvent configuré sur les interfaces en bordure du réseau), en
fonction du type de service et du trafic.
Là aussi, on se place sur l'interface voulue, puis on configure CAR:
Router(config)- interface type numero
Router(config)- rate-limit input [access-group[rate-limit]acl-index] bps burst-normal burst-max conform-action action exceed-action action
#Par exemple:
Router(config)- ip access-list 101 permit ip host X.Y.Z.W any
Router(config)- int g0/0
#ici, si le trafic en provenance de X.Y.Z.W est inferieur a 496000 bps, il sera envoye avec la precedence 4. Sinon il sera envoye avec la precedence 0.
Router(config-if)- rate-limit input access-list 101 496000 32000 64000 conform-action set-prec-transmit 4
Router(config-if)- do sh int g0/0 rate-limit
Et enfin, /Class Based Weighted Fair Queuing/, CBWFQ, qui détermine
automatiquement, via un poids assigné (une priorité), la bande passante
allouée à un type de service. WFQ essaie d'allouer raisonnablement la
bande passante disponible entre les différents types de trafic réseau.
Par exemple en sortie de notre réseau:
Router(config)- class-map match-all prec_01
Router(config-cmap)- match ip precedence 0 1
Router(config-cmap)- ex
Router(config)- class-map match-all prec_23
Router(config-cmap)- match ip precedence 2 3
Router(config-cmap)- ex
Router(config)- policy-map outputmap
Router(config-pmap)- class prec_01
Router(config-pmap)- bandwith 10000
Router(config-pmap)- class prec_23
Router(config-pmap)- bandwith 20000
Router(config-pmap)- ex
Router(config)- int g0/0
Router(config-if)- service-policy output outputmap
Router(config-if)- do sh policy-map int g0/0